Prorise
这是我的博客,分享技术与生活的点点滴滴
Vue 生态(番外):零后端依赖!使用 JSON Server 快速构建 RESTful API
Vue 生态(番外):零后端依赖!使用 JSON Server 快速构建 RESTful API
Prorise第一章:基础入门 · 构建与消费你的第一个 API 服务器
摘要: 本章是 JSON Server 的“Hello, World!”,但我们将以专业前端工程师的视角来开启它。我们将直面“等待后端接口”的开发瓶颈,然后在一个标准的 Vite + Vue 项目中,集成 axios 并构建一个 可复用的服务层 来封装所有 API 请求。随后,我们将启动 JSON Server,并通过我们亲手编写的服务,完成对 Mock 服务器的完整 CRUD 操作。学完本章,你将同时掌握“构建”和“消费”一个高保真 Mock API 的核心能力,并习得一套专业的 API 请求管理模式。
本章地图
- 直面痛点: 我们将明确为何需要 API Mock,并对比
Mock.js与JSON Server的核心差异。 - 专业起步: 我们将初始化 Vite 项目,安装
json-server与axios,并构想和创建一个 服务层,用以封装所有 API 逻辑。 - 启动与对接: 我们将创建
db.json并启动JSON Server,然后在 Vue 组件中调用我们封装的服务,实现前后端的首次“握手”。 - 实战交互: 我们将通过组件与服务层的优雅协作,完整地实战
JSON Server提供的复数路由与单数路由。
1.1. 痛点:前端开发的“等待之痛”与 Mock 方案的抉择
在真实的项目协作中,我们经常会遇到这样一种令人沮丧的窘境:作为前端开发者,你已经依据 UI/UX 设计稿,用最快的速度完成了页面的静态布局和组件搭建。你万事俱备,只等后端同学提供数据接口,以便进行数据联调和后续开发。
然而,你得到的答复往往是:“接口还在开发中,下周才能提测。”
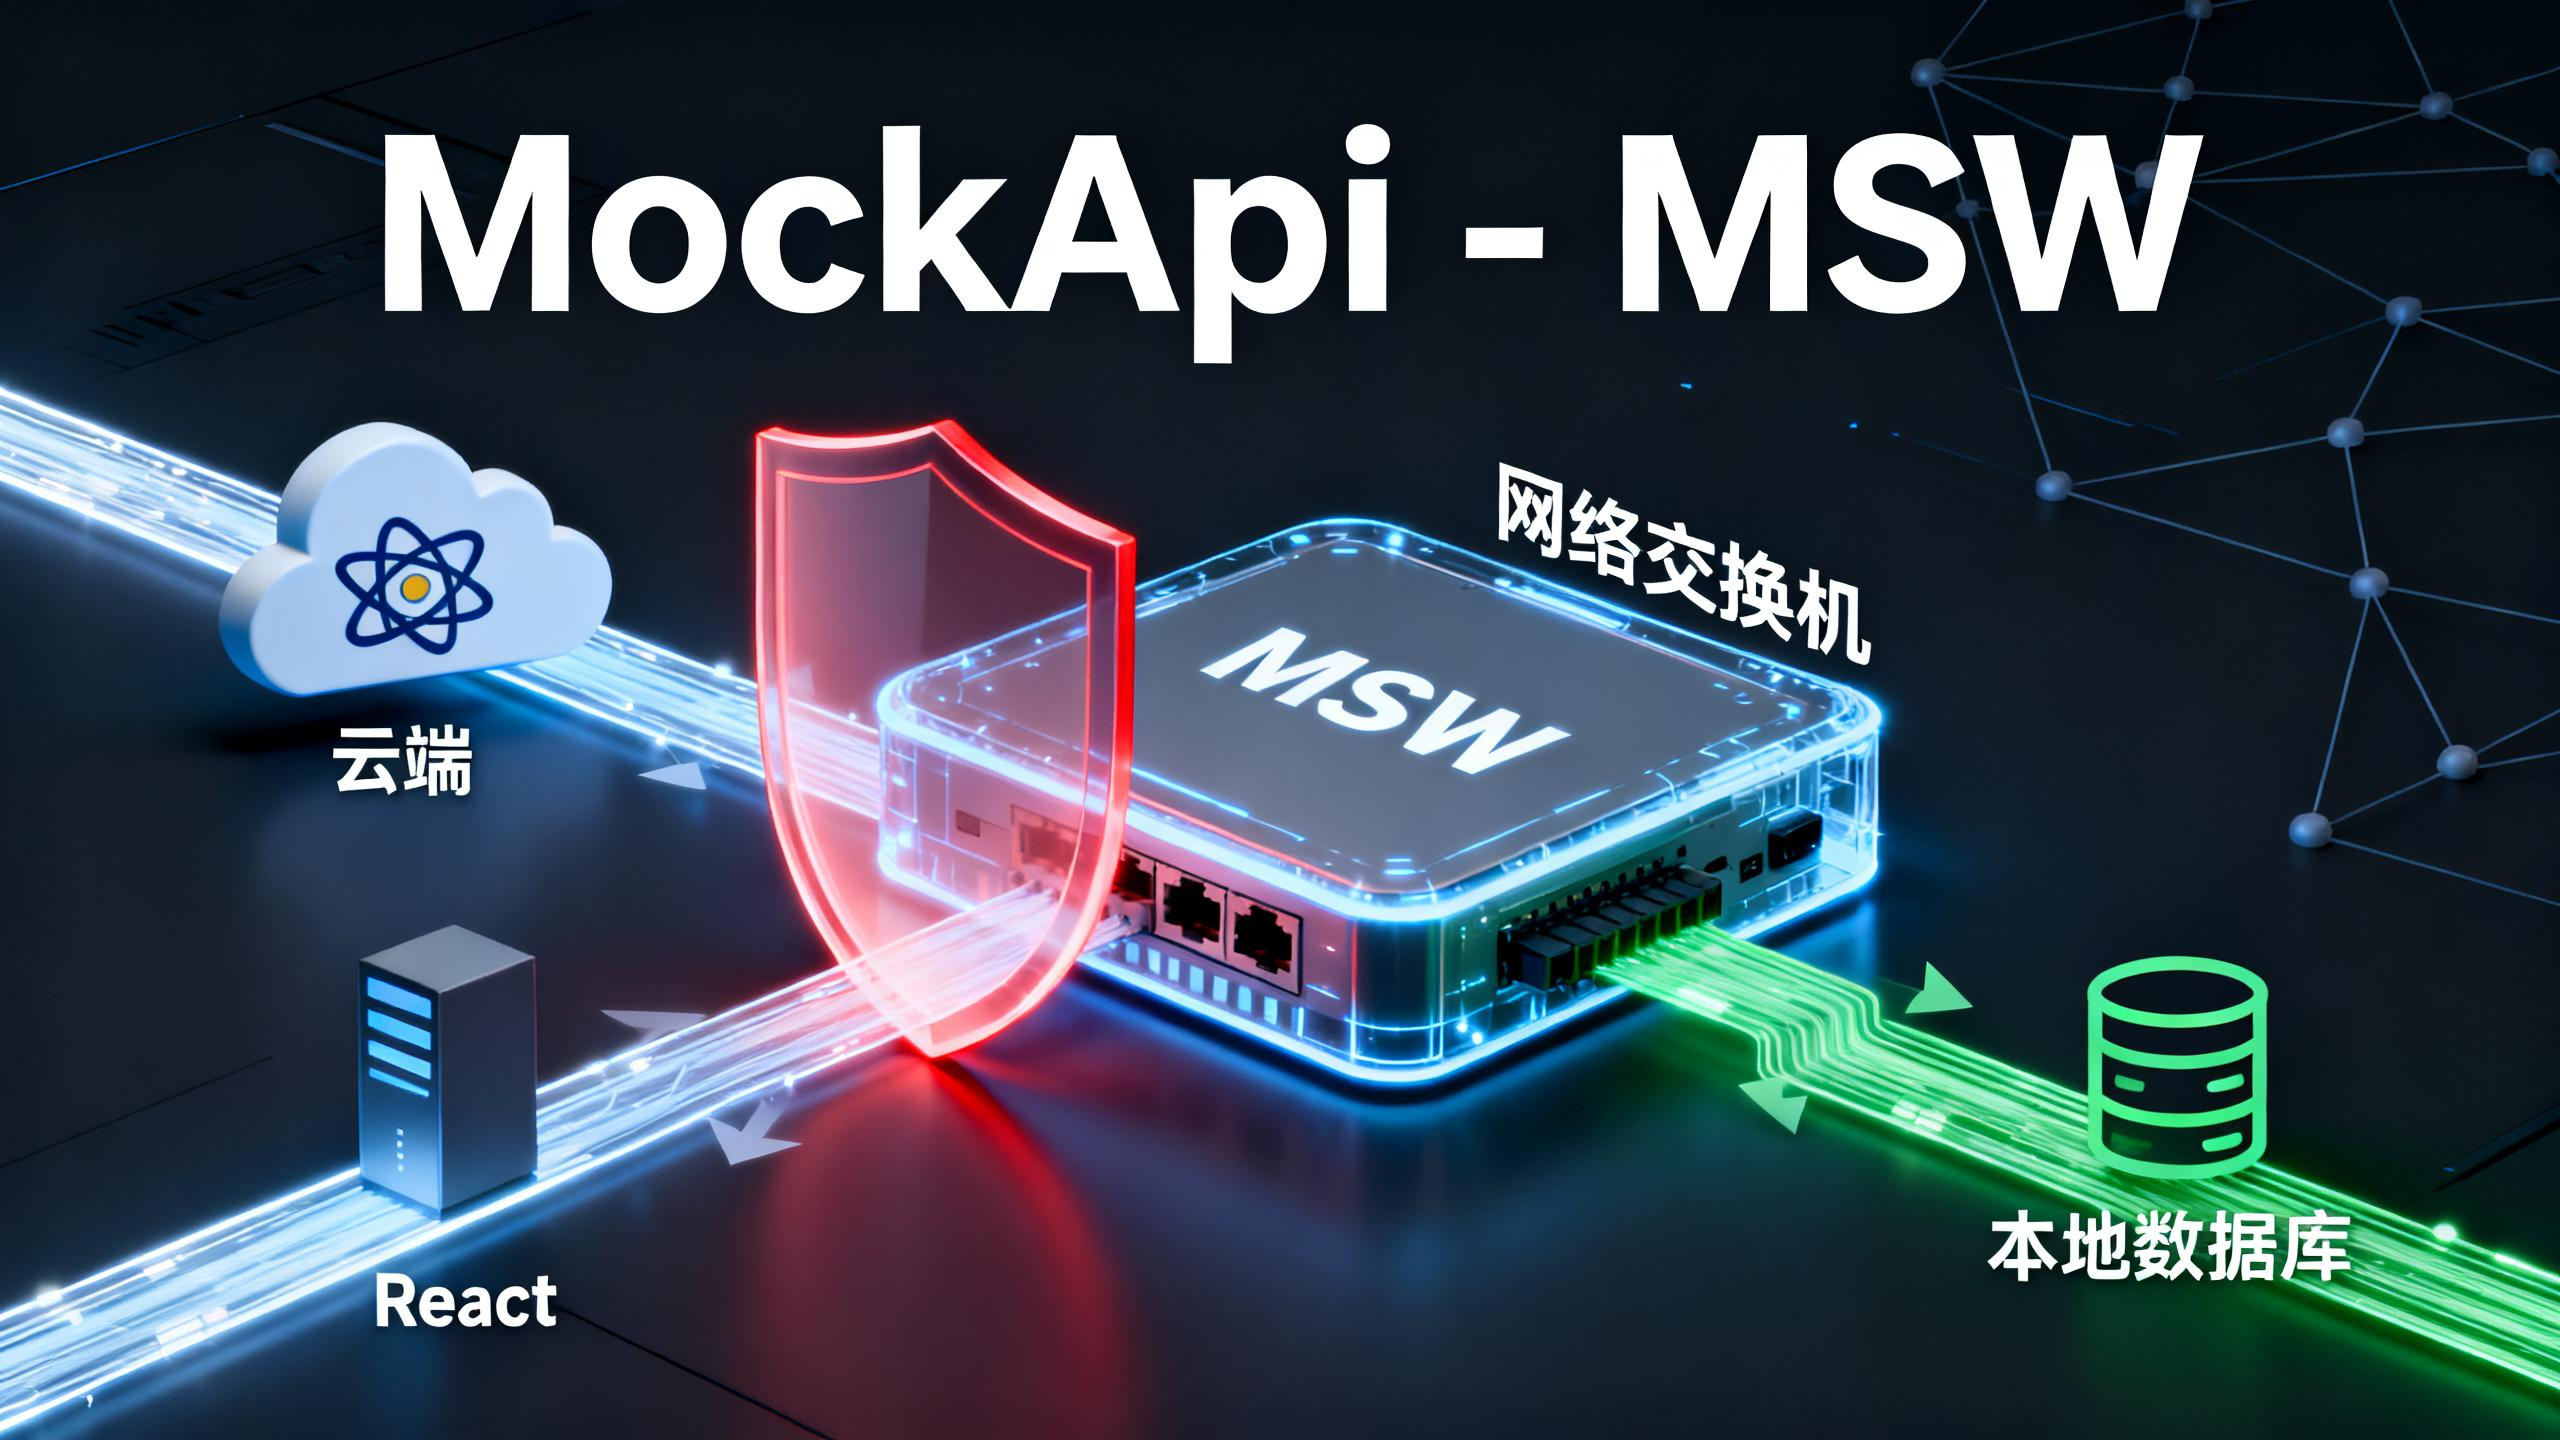
此刻,你的工作流被迫中断。为了不延误项目进度,引入“模拟数据 (Mock Data)”成为了必然选择。在前端生态中,主流的 Mock 方案通常遵循两种不同的哲学:
哲学一:前端请求拦截与数据伪造。
这种模式的代表是 Mock.js。它的工作方式是在前端应用内部,通过拦截 Ajax 请求(例如,使用 axios 的拦截器),阻止其真实地发送到网络上。一旦拦截到匹配的请求,就返回一串由 Mock.js 按照预设规则 随机生成 的假数据。
哲学二:本地真实 API 服务器模拟。
这种模式的代表正是我们本章的主角 JSON Server。它不在前端应用内部做任何文章,而是独立运行一个 真实的、微型的 Web 服务器。你的前端应用会像请求真实后端一样,向这个本地服务器 (http://localhost:3001) 发送网络请求,而这个服务器则会像真实后端一样,给予规范的响应。
结论:对于我们即将学习的、需要处理数据增删改查并管理其状态的场景而言,JSON Server 是无疑是更优的选择。它让我们的前端代码无需任何 Mock 相关的“污染”,保持了生产环境的纯净性,同时提供了一个可交互、有记忆的后端模拟。
1.2. 专业起步:环境搭建与服务层封装
现在,我们正式开始搭建我们的实战环境,并引入服务层的架构思想。
第一步:初始化 Vite 项目
1 | pnpm create vite json-server-lab --template vue-ts |
第二步:安装核心依赖
我们需要两个核心库:json-server 用于模拟后端,axios 用于发送前端请求。
1 | # 安装 json-server 作为开发依赖,很遗憾作者已经停更了,新版本远不如稳定版来的划算,所以我们限制版本在 0.17.4 |
第三步:创建并封装 API 服务层
这是本次重写的核心。我们将遵循 关注点分离 的原则,将所有与 API 通信相关的逻辑,都封装到一个专门的“服务层”中。组件将不再关心 axios 或具体的 URL,只负责调用服务。
1. 创建 axios 实例
首先,我们创建一个可复用的 axios 实例,用于统一配置。
文件路径: src/api/apiClient.ts (新增)
1 | import axios from 'axios'; |
2. 封装 posts 资源的服务
接着,我们为 posts 这个数据资源创建一个专门的服务文件。
文件路径: src/api/services/postsService.ts (新增)
1 | import apiClient from "../apiClient"; |
通过这种方式,我们为 posts 资源创建了一套类型安全、语义清晰的 API 服务。组件将通过调用这些函数来与后端交互。
第四步:配置并启动 JSON Server
最后,我们创建“数据库”并配置启动脚本。
文件路径: db.json (新增)
当我们的 db.json 顶层为一个数组时,json-server 就会为我们生成一套增删改查的 restful 系统
1 | { |
文件路径: package.json (修改 scripts 部分)
1 | { |
现在,打开 第一个终端 启动 Mock 服务器 (pnpm run mock),再打开 第二个终端 启动 Vite 项目 (pnpm run dev)。我们的专业开发环境已准备就绪。
1.3. 实战交互:组件与服务层的优雅协作
有了封装好的服务层,我们的 Vue 组件现在可以变得极为清爽,只专注于自己的核心职责:调用服务、管理状态和渲染 UI。
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
通过这次重构,我们的 App.vue 组件变得职责单一、清晰可读。它完全不知道 axios 的存在,也不知道 API 的具体路径是什么。它只通过一个清晰的、类型安全的服务层接口来与外部世界通信。这,就是现代前端工程中处理数据交互的 最佳实践。
1.4. 交互核心原则:避开常见陷阱
摘要: 在你开始兴奋地使用 POST, PUT, PATCH 等方法与你的 Mock API 进行交互之前,我们需要稍作停留,探讨两条由 HTTP 协议和 RESTful 最佳实践所衍生的“黄金法则”。它们是 json-server 乃至绝大多数真实后端 API 都默默遵守的“潜规则”。提前掌握它们,能让你在开发中避免 90% “请求成功了,但数据没变”的诡异问题。
原则一:Content-Type 的强制性——明确告知服务器你的“语言”
“陷阱”场景
想象一下这个令人困惑的场景:你通过代码发送了一个 POST 请求去创建一个新帖子,开发者工具的网络面板显示请求状态为 200 OK,一切看起来都完美无缺。但当你刷新列表或检查 db.json 文件时,却发现新帖子根本没有被创建。
这是新手在使用 axios 或原生 fetch 时最常遇到的问题,其根源在于你没有明确告知服务器,你发送给它的数据主体(Request Body)是什么格式。
核心原则
对于任何需要携带数据主体的“写”操作 (POST, PUT, PATCH),客户端 必须 在请求头 (Headers) 中包含 Content-Type: application/json。
“为什么”要这么做?
这个请求头就像是在对服务器说:“你好,我接下来要发送给你的数据,是 JSON 格式的,请你用 JSON 解析器来处理它。”
如果没有这个“声明”,json-server(以及大多数后端框架)会收到你的数据,但它不知道该如何解读这串字节流。出于安全和规范的考虑,它会选择直接忽略这个它不理解的请求体,即便它会礼貌地返回一个 200 OK 状态码。
最佳实践:在服务层一劳永逸地解决
这正是我们在 1.2 节建立 apiClient.ts 的价值所在。我们可以在创建 axios 实例时,就将其作为默认配置,确保我们的每一次请求都符合规范。
文件路径: src/api/apiClient.ts (回顾与确认)
1 | import axios from 'axios'; |
幸运的是,axios 库的设计者已经预见到了这一点,通常会自动为写操作添加此请求头。但作为“架构师学徒”,我们必须清晰地知道这个行为的存在及其背后的原理,而不是仅仅依赖于框架的“魔法”。
原则二:ID 的不可变性——资源的唯一身份标识
“陷阱”场景
你尝试通过一个 PUT 请求去更新一篇文章,不仅想修改它的标题,还想顺便修改它的 id:
1 | // 尝试将 id=1 的文章,其 id 修改为 99 |
请求成功了,文章的 title 和 author 都被更新了,但当你再次获取这篇文章时,发现它的 id 依然是 1,而不是你期望的 99。
核心原则
在 RESTful 架构中,资源的 id 是其在数据库中的唯一主键,是其不可变更的“身份证号”。因此,json-server 会完全忽略 PUT 或 PATCH 请求体中包含的任何 id 字段。
“为什么”要这么做?
“更新” (Update) 操作的语义是“在原地修改一个现有资源的内容”。而修改 id 实质上等于“删除了一个旧资源,同时创建了一个新资源”,这已经超出了 PUT/PATCH 的职责范围。
唯一可以设置 id 的时机,是在 POST 创建一个全新资源的时候。当然,如果你在 POST 时不提供 id,json--server 会为你自动生成一个。
总结: 请将这两条原则刻在你的脑海里:
- 写操作,必带
Content-Type: application/json。 id在创建后,永不更改。
理解并遵守这两个看似简单的规则,将为你扫清通往更高级功能路上的诸多障碍,让你能够更专注于业务逻辑的实现,而不是在基础的通信协议上反复调试。
第二章:高级查询 · 模拟真实世界的复杂 API
摘要: 基础的 CRUD 只是起点。一个专业的 API 还需要具备强大的数据查询与筛选能力。本章,我们将深入探索 JSON Server 丰富且直观的查询参数体系。我们将学习如何实现 多条件过滤、服务端分页、动态排序 等一系列高级查询。更重要的是,我们会将这些能力,通过重构我们的 API 服务层,以一种类型安全、可扩展的方式提供给前端组件,最终构建出一个功能完善、体验真实的动态数据列表。
- 服务层重构: 我们将首先重构
postsService,使其能够接收动态的查询参数,为实现高级查询奠定架构基础。 - 数据筛选: 学习
JSON Server的 过滤器 (Filters),实现如“按作者搜索”等功能。 - 分页加载: 学习
_page和_limit参数,为我们的文章列表加上 分页 功能,并理解如何获取总数。 - 动态排序: 学习
_sort和_order参数,让用户可以 自定义排序 规则。 - 进阶查询: 快速掌握 运算符 (
_gte,_like) 和 全文检索 (q) 等更精细的查询工具。
2.1. 基础重构:打造一个可查询的服务
我们当前 getAllPosts 服务是一个“硬编码”的函数,它只能获取全部文章。为了支持后续的各种查询,我们必须先对其进行重构,让它能够接收一个动态的参数对象。这是一种重要的架构思想:将不变的逻辑(请求路径)与变化的逻辑(查询参数)分离。
定义查询参数类型
一个良好的实践是为所有可能的查询参数定义一个 TypeScript 接口,作为服务与组件之间清晰的“契约”。
文件路径: src/api/services/postsService.ts (修改)
1 | // ... Post 和 CreatePostPayload 接口保持不变 ... |
重构 getAllPosts 服务
我们让 getAllPosts 接收这个参数对象,并将其传递给 axios。axios 会智能地将这个对象序列化为 URL 查询字符串。
文件路径: src/api/services/postsService.ts (修改)
1 | // ... 接口定义 ... |
这次重构是本章最重要的基础。现在,我们的 getAllPosts 服务拥有了接收任意查询条件的“超能力”,准备好应对各种复杂的查询场景。
2.2. 数据筛选 (Filters)
JSON Server 允许你直接通过查询参数对任何字段进行精确匹配。这是构建搜索功能最直接的方式。
实战:在 App.vue 中添加按作者筛选的功能
我们将在 App.vue 中增加一个输入框,用于接收用户输入的作者名,并在请求时将其作为参数传递给我们的服务。
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
现在,在输入框中输入 作者名 并按回车或点击搜索,JSON Server 将只返回 author 字段为 作者 的文章。JSON Server 还支持更复杂的筛选:
多条件 (与): ?title=...&author=...
多值 (或): ?id=1&id=2
深度过滤: ?address.city=Gwenborough (如果数据有嵌套)
你只需在 PostQueryParams 接口和 fetchPosts 函数中增加相应的逻辑即可轻松支持。
2.3. 分页加载(Page)
当数据量巨大时,一次性加载所有数据是不可接受的。JSON Server 内置了标准的服务端分页支持。
核心参数
_page: 指定请求的页码(从 1 开始)。_limit: 指定每页返回的数据条数。
关键响应头
X-Total-Count:JSON Server会在分页请求的响应头中,通过这个字段返回该资源的总记录数。这是我们计算总页数的关键。
实战:为文章列表添加分页
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
2.4. 动态排序 (Sorting)
核心参数
_sort: 指定用于排序的字段名。_order: 指定排序顺序,asc(升序) 或desc(降序)。
实战:添加按标题或作者排序功能
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
现在,我们已经为应用实现了企业级后台常见的全部核心查询功能:筛选、分页和排序。我们的服务层和组件也展现出了良好的扩展性。
2.5. 进阶查询:运算符与全文检索
我们已经掌握了筛选、分页和排序,这足以构建一个功能强大的数据列表。然而,在真实的应用场景中,我们往往需要更精细、更智能的查询能力。JSON Server 同样为我们提供了这些“进阶武器”。
本节,我们将学习两种最实用的高级查询技术:
- 运算符 (Operators): 实现基于字段的模糊搜索、范围查询等。
- 全文检索 (Full-Text Search): 实现跨字段的全局关键字搜索。
使用运算符进行精准筛选
JSON Server 允许我们在查询参数的字段名后,追加 _ 和指定的运算符,来实现超越简单“等值匹配”的查询。
最常用的运算符包括:
_like: 进行模糊匹配(子字符串查询)。这对于实现搜索框的即时建议功能至关重要。_gte: Greater than or equal to (大于或等于> =)。_lte: Less than or equal to (小于或等于<=)。_ne: Not equal to (不等于!=)。
为了在我们的服务层中支持这些动态的、带后缀的查询键(如 title_like, views_gte 等),我们需要对 PostQueryParams 接口进行一次小小的升级,使用 索引签名 来增加其灵活性。
文件路径: src/api/services/postsService.ts (修改)
1 | // ... Post 和 CreatePostPayload 接口保持不变 ... |
现在,我们的服务层已经准备好接收任何形式的运算符查询了。让我们在 App.vue 中实战 title_like 功能。
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
现在,在“按标题模糊搜索”框中输入 模糊内容 并搜索,JSON Server 将会返回所有标题中包含 模糊内容 字符串的文章。
使用 q 参数进行全文检索
q 参数是 JSON Server 提供的一个极其便利的功能。它会在一个资源的所有字段中,进行不区分大小写的全文检索。这非常适合用于实现一个“全局搜索”框。
实战:添加全局搜索功能
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
现在,如果你在全局搜索框中输入内容,即使 title 字段不包含它,JSON Server 也会因为 author 字段匹配到了内容而返回对应的文章记录。
2.6. 数据分片 (Slicing):另一种数据截取范式
在上一节,我们学习了分页 (Paging),这是一种非常经典和通用的数据获取方式,它将数据集合划分为固定大小的“页”。然而,在某些现代 UI 模式中,尤其是“无限滚动”或需要按任意区间加载数据的场景下,基于“页码”的思维模式会显得有些笨拙。
为了应对这些场景,JSON Server 提供了另一种更底层、更灵活的数据截取机制——分片 (Slicing)。
2.6.1. 核心思想:从“页”到“索引”的转变
让我们首先厘清分页与分片的核心思想差异:
分页 (Paging):你关心的是 “第几页” 和 “每页多少条”。你告诉服务器:“给我第 3 页的数据,每页 10 条。” 服务器内部会计算出
(3 - 1) * 10,然后从第 20 条记录开始,取 10 条数据返回给你。这是一种高度抽象和封装的模式。分片 (Slicing):你关心的是数据的 “起始索引” 和 “结束索引”。你直接告诉服务器:“给我从索引号 20 开始,到索引号 30 结束的数据。” 这种模式与 JavaScript 中的
Array.prototype.slice(start, end)方法在思想上完全一致,它给了前端开发者更直接、更精确的数据控制权。
2.6.2. 核心参数
JSON Server 通过以下三个参数来实现分片功能:
_start: 指定截取的 起始索引(从 0 开始)。这个索引位置的元素 会被包含 在结果中。_end: 指定截取的 结束索引。这个索引位置的元素 不会被包含 在结果中,形成一个“半包”区间[start, end)。_limit: 这个参数可以与_start组合使用,表示从_start索引开始,连续获取_limit条记录。这在实现“加载更多”功能时非常方便。
关键响应头: 和分页一样,使用分片进行请求时,JSON Server 同样会在响应头中返回 X-Total-Count 字段,告诉你该资源的总记录数。这对于计算滚动条位置、判断是否已加载全部数据至关重要。
2.6.3. 实战:改造服务与组件以支持分片
现在,我们将这个新能力集成到我们的项目中。
第一步:更新 PostQueryParams 接口
我们需要在服务层的类型定义中,加入对 _start 和 _end 的支持。
文件路径: src/api/services/postsService.ts (修改)
1 | // ... Post 和 CreatePostPayload 接口保持不变 ... |
第二步:在 App.vue 中演示分片加载
为了清晰地演示分片的效果,我们将暂时移除分页逻辑,并添加一个按钮来加载指定索引区间的数据。
文件路径: src/App.vue (修改)
1 | <script setup lang="ts"> |
现在,运行你的 Vite 项目和 mock 服务。页面初始会加载索引 0 到 9 的文章。当你点击“加载索引 [10, 20) 的文章”按钮时,列表会更新为索引 10 到 19 的文章数据。
2.6.4. “无限滚动”场景的思考
有了分片的能力,实现一个“无限滚动”列表的逻辑就变得非常清晰了:
- 维护状态: 在组件中维护一个
currentIndex变量,初始值为 0,以及一个pageSize(例如 10)。 - 首次加载: 页面加载时,调用
getAllPosts({ _start: 0, _limit: pageSize })。 - 监听滚动: 监听页面的滚动事件。当用户滚动到页面底部时,触发加载更多逻辑。
- 加载更多:
- 更新
currentIndex = currentIndex + pageSize。 - 调用
getAllPosts({ _start: currentIndex, _limit: pageSize })获取下一批数据。 - 将新获取的数据追加到现有的
posts数组中。
- 更新
- 终止条件: 当某次请求返回的数据量小于
pageSize,或者currentIndex已经超过totalPosts时,停止监听滚动,并显示“没有更多了”的提示。
1 | <script setup lang="ts"> |
总结: 数据分片 (Slicing) 为前端提供了原子级别的、基于索引的数据请求能力。它虽然比分页 (Paging) 更底层,但在实现无限滚动、虚拟列表等需要精确控制数据窗口的场景下,是一种更强大、更符合直觉的工具。掌握了它,意味着你的工具箱里又多了一件应对复杂数据加载需求的利器。
2.7. 本章核心回顾与速查
摘要: 在本章中,我们完成了一次至关重要的蜕变:从仅仅能“获取全部数据”,进化到能够随心所欲地对数据进行 “筛选、排序、截取”。我们不仅学习了 JSON Server 提供的一系列强大查询参数,更重要的是,我们通过对 服务层 (postsService) 的持续重构,建立了一套可扩展、类型安全的 API 查询架构。这套架构思想,将是你未来职业生涯中构建任何复杂数据驱动应用的重要基石。
思想升华:从“数据请求者”到“数据指挥家”
回顾本章的旅程,我们的核心收获并不仅仅是记住几个以下划线开头的参数。真正的价值在于我们思维模式的转变:
架构先行: 我们做的第一件事,也是最重要的一件事,就是将
getAllPosts函数从一个无参数的“死”函数,重构为一个接收动态params对象的“活”函数。这一步,为后续所有高级查询能力的注入打开了大门。这正是“架构师学徒”所追求的——通过良好的设计,让系统拥抱变化。解锁“数据显微镜”: 通过学习 过滤器 (Filters)、运算符 (Operators) 和 全文检索 (q),我们获得了对数据的精细控制能力。我们不再是被动地接收整个数据集,而是可以像使用显微镜一样,精确地定位到我们需要的任何一个数据子集。无论是“查找李四发布的所有标题包含‘Vue’的文章”,还是“全局搜索包含‘pnpm’关键字的任何内容”,都已尽在掌握。
掌握两种“数据传输带”: 面对海量数据,我们学习了两种核心的解决方案:
- 分页 (Paging): 经典、可靠,是构建传统后台表格、文章列表等 UI 的基石。我们重点掌握了通过
X-Total-Count响应头来构建完整分页 UI 的核心技巧。 - 分片 (Slicing): 更底层、更灵活,是实现无限滚动、虚拟列表等现代 UI 模式的利器。它让我们从“页”的束缚中解放出来,回归到更本质的“索引”层面进行操作。
- 分页 (Paging): 经典、可靠,是构建传统后台表格、文章列表等 UI 的基石。我们重点掌握了通过
学完本章,你的前端应用在与 Mock API 交互时,已经具备了与一个真实、成熟的后端系统对话的能力。你不再是一个只会 GET /posts 的初学者,而是一个能够清晰地向后端表达复杂数据需求的“数据指挥家”。
核心功能速查表
以下是本章所有核心查询参数的速查表。在你未来的实战中,它可以作为你快速回忆和查阅的“第二大脑”。
| 分类 | 关键项 | 核心描述与用法示例 |
|---|---|---|
| 基础筛选 | [field]=value | (精确匹配) 筛选出字段 field 的值等于 value 的所有记录。< br > GET /posts?author=typicode |
| 基础筛选 | [field].path=value | (深度过滤) 当字段值为对象时,通过 . 访问其深层属性进行过滤。< br > GET /users?address.city=Gwenborough |
| 分页 | _page=<number> | 指定要获取的数据页码,页码从 1 开始。< br > GET /posts?_page=2 |
| 分页 | _limit=<number> | 指定每页返回的记录数量。< br > GET /posts?_page=2&_limit=10 |
| 分页 | X-Total-Count (响应头) | (总数获取) 在分页请求的响应头中,JSON Server 会通过此字段返回该资源的总记录数。 |
| 数据分片 | _start=<number> | (起始索引) 从索引 number 处开始截取(包含此索引)。< br > GET /posts?_start=20 |
| 数据分片 | _end=<number> | (结束索引) 截取到索引 number 之前(不包含此索引)。< br > GET /posts?_start=20&_end=30 |
| 数据分片 | _start & _limit | (组合使用) 从 _start 索引开始,获取 _limit 条记录。< br > GET /posts?_start=0&_limit=5 |
| 排序 | _sort=<field> | 指定用于排序的字段。可提供多个字段,用逗号分隔。< br > GET /posts?_sort=author,title |
| 排序 | _order=<asc|desc> | 指定排序顺序(升序/降序)。可对应多个排序字段。< br > GET /posts?_sort=views&_order=desc |
| 高级筛选 | [field]_like=<string> | (模糊搜索) 筛选出 field 字段值包含 string 子字符串的所有记录。< br > GET /posts?title_like=awesome |
| 高级筛选 | [field]_gte=<number> | 筛选出 field 字段值 大于或等于 指定值的记录。< br > GET /posts?views_gte=1000 |
| 高级筛选 | [field]_lte=<number> | 筛选出 field 字段值 小于或等于 指定值的记录。< br > GET /posts?views_lte=50 |
| 高级筛选 | [field]_ne=<value> | 筛选出 field 字段值 不等于 指定值的记录。< br > GET /posts?id_ne=1 |
| 全文检索 | q=<string> | (全局搜索) 在一个资源的所有字段中,进行不区分大小写的全文检索。< br > GET /posts?q=pnpm |
第三章:专业进阶 · 完全掌控你的 Mock API
摘要: 查询只是 API 的一部分。一个专业的后端模拟,还需要处理数据间的复杂关系、具备生成海量数据的能力,甚至需要模拟自定义的业务逻辑(如权限验证)。本章,我们将深入 JSON Server 的“专家模式”。你将学会如何处理 连表查询、如何 动态生成海量数据、如何 自定义 API 路由,并最终掌握将其作为 Node.js 模块使用的终极武器,让你能够通过中间件注入任何你想要的逻辑,打造出一个无限接近真实后端的、高保真的 Mock 环境。
3.1. 处理数据关系:连表查询 (Relationships)
在真实的业务数据中,资源之间很少是孤立的。文章 (posts) 拥有评论 (comments),评论属于某篇文章;文章有作者,作者是用户 (users)。在前端,如果我们需要展示一篇文章及其所有评论,一种天真的做法是:
- 请求
GET /posts/1获取文章信息。 - 再请求
GET /posts/1/comments获取该文章的评论列表。
这种需要多次网络往返来“拼凑”数据的模式,被称为 “N+1 查询瀑布”,是前端性能的一大杀手。一个设计良好的后端 API,通常会通过“连表查询”机制,让前端可以在一次请求中获取到所有需要的主体数据和关联数据。
JSON Server 通过 _expand 和 _embed 这两个强大的参数,完美地模拟了这一核心能力。
第一步:准备具有关联关系的数据
为了演示连表查询,我们首先需要扩充 db.json,建立 posts 和 comments 之间清晰的父子关系。
文件路径: db.json (修改)
1 | { |
请注意: 我们将 id 改为字符串形式(如 "p1", "c1")以模拟更真实的场景。comments 中的 postId 字段,就是关联到 posts id 的“外键”。
3.1.1. _expand:展开父资源 (获取评论及其所属文章)
当你获取一个“子”资源(如 comment),并希望同时带上其“父”资源(如 post)的完整信息时,使用 _expand。
JSON Server 会根据 [resource]Id 这样的命名约定(如 postId)来识别外键。?_expand=post 的含义是:“请在返回的 comment 数据中,将 postId 字段展开为完整的 post 对象”。
请求示例: GET http://localhost:3001/comments/c1?_expand=post
1 | { |
你看,我们只发起了一次请求,就同时拿到了评论和它所属的文章信息。
3.1.2. _embed:嵌入子资源 (获取文章及其所有评论)
当你获取一个“父”资源(如 post),并希望同时带上其下所有的“子”资源(如 comments)时,使用 _embed。
?_embed=comments 的含义是:“请在返回的 post 数据中,嵌入一个名为 comments 的数组,该数组包含所有 postId 等于当前 post id 的评论”。
请求示例: GET http://localhost:3001/posts/p1?_embed=comments
1 | { |
同样地,一次请求就获取了文章和它的全部评论,完美解决了 N+1 问题。
3.1.3. 服务层与组件集成实战
现在,我们将这些能力集成到我们的 postsService 和 App.vue 中。
第一步:更新服务层类型与方法
文件路径: src/api/services/postsService.ts (修改)
1 | // ... apiClient ... |
第二步:在组件中消费带关联数据的 API
文件路径: src/App.vue (简洁的修改)
1 | <script setup lang="ts"> |
现在,点击按钮,你的应用将只发起一次网络请求,就能渲染出包含文章和其所有评论的完整视图。通过 _expand 和 _embed,我们的 Mock API 在数据关联的处理上,已经具备了相当高的真实性。
3.2. 摆脱静态 JSON:动态数据生成
在前面的章节中,我们的 db.json 文件一直扮演着“微型数据库”的角色。对于功能验证来说,这非常方便。但当我们需要测试更真实的场景时——例如,一个需要处理上百条数据的分页表格,或一个需要展示多样化用户信息的列表——手动编写一个庞大且内容丰富的 db.json 文件,就变成了一项枯燥、低效且难以维护的工作。
为了解决这个痛点,JSON Server 提供了一个强大的特性:它不仅可以加载静态的 .json 文件,还可以执行一个 .js 文件,并将其导出的数据对象作为 API 的数据源。
这为我们打开了新世界的大门:我们可以利用 JavaScript 的编程能力,结合专业的数据伪造库,来程序化地生成任意数量、任意结构的逼真模拟数据。
3.2.1. 我们的新朋友:认识 Faker.js
在开始编码前,我们必须先隆重介绍即将为我们提供“无限弹药”的强大盟友——@faker-js/faker。
Faker 是一个非常流行的库,其唯一的使命就是生成海量的、看起来非常 逼真 的假数据。它和简单的 Math.random() 有着本质区别。Faker 生成的数据是 有语义 的,这对于构建高保真的 UI 原型至关重要。
为什么需要“逼真”的数据?
想象一下,你的 UI 布局在显示“测试用户 1”时完美无缺,但在显示一个真实的、长短不一的外国人名(如 Mrs. Odell Corwin)时,可能会出现换行或溢出。使用 Faker 生成的逼真数据,可以帮助我们在开发阶段就提前发现并修复这类与内容相关的 UI 问题。
Faker 的能力一瞥
| API 调用 | 示例输出 |
|---|---|
faker.person.fullName() | Brendan Gleichner |
faker.internet.email() | Brendan.Gleichner23@hotmail.com |
faker.lorem.sentence() | The automobile layout consisted of a sedan. |
faker.image.avatar() | https://avatars.githubusercontent.com/u/1234567 |
faker.finance.amount() | 841.25 |
Faker 几乎可以为你业务中需要的任何数据类型,提供符合其格式和语义的模拟数据。
现在,让我们正式将这位新朋友集成到我们的项目中。
3.2.2. 第一步:安装依赖
在你的 json-server-lab 项目中,将 @faker-js/faker 安装为开发依赖:
1 | pnpm add -D @faker-js/faker |
3.2.3. 第二步:创建数据生成脚本
最简单的解决方案是将文件命名为 .cjs 扩展名,这样 Node.js 就会将其作为 CommonJS 模块处理。
现在,我们创建一个 generate-data.cjs 文件来替代 db.json。
文件路径: generate-data.cjs (新增)
1 | const { faker } = require("@faker-js/faker"); |
这个脚本导出了一个函数。当 JSON Server 加载这个文件时,它会执行此函数,并将返回的 data 对象作为内存中的数据库。我们利用 faker 库,在循环中轻松地创建了 500 条结构一致但内容各异的文章数据。
3.2.4. 第三步:更新启动命令
现在,我们需要告诉 JSON Server 去加载我们的新脚本,而不是旧的 db.json。
文件路径: package.json (修改 mock 脚本)
1 | { |
注意:由于数据是在服务器启动时一次性生成的,--watch 参数对于 .js 文件意义不大,因此可以省略。如果你修改了 generate-data.cjs,需要重启 mock 服务才能生效。
3.2.5. 第四步:验证成果
文件路径: src/api/services/postsService.ts (修改)
1 | // ... |
文件路径: /src/app.vue (修改)
1 | <script setup lang="ts"> |
- 确保你已经停止了之前运行的
mock服务 (Ctrl+C)。 - 在终端运行新的启动命令:
pnpm run mock。 - 刷新你的 Vite 应用页面 (或直接访问
http://localhost:3001/posts)。
你将看到,你的文章列表现在充满了由 Faker 生成的、足足 500 条丰富多彩的数据。我们之前在第二章中实现的分页、筛选和排序功能,现在终于有了用武之地,你可以在这个庞大的数据集上尽情测试它们的表现。
通过程序化生成数据,我们成功地将模拟数据的 结构定义(在脚本中)与 内容填充(由 Faker 完成)分离开来。这使得创建和维护大规模、高保真的测试数据集变得轻而易举,是专业前端开发中进行复杂 UI 测试和性能评估的必备技巧。
3.4. 锦上添花:提升效率的辅助特性
摘要: 一个专业的工具箱里,除了完成核心任务的重型装备,还应该有一些精巧、锋利的小工具,它们能在特定场景下极大地提升我们的工作效率。本节,我们将学习 JSON Server 提供的三个辅助特性:数据库快照 (/db)、静态文件服务 (--static) 和 远程数据源。它们将分别帮助我们更高效地进行调试、快速原型验证和团队协作。
3.4.1. 全局数据库快照 (/db):你的终极调试窗口
痛点分析
在开发过程中,你可能会频繁地通过前端页面或 Postman 等工具对数据进行增、删、改。几轮操作下来,你可能会有一个疑问:现在服务器内存里,完整、真实的数据状态 到底是什么样的?尤其是当我们使用 .js 脚本动态生成初始数据后,磁盘上已经没有一个静态的 db.json 文件可供参考了。
解决方案JSON Server 提供了一个极其有用的内置端点:GET /db。访问这个端点,你将得到一个 JSON 响应,其中包含了当前服务器内存中所有资源的完整数据快照。
实战用法
- 启动你的
mock服务。 - 在前端页面上进行任意多次的“新增文章”、“删除文章”操作。
- 在浏览器中打开一个新的标签页,访问
http://localhost:3001/db。
你将看到一个包含了 posts, comments, profile 等所有资源的 JSON 对象,其内容精确地反映了你刚才所有操作之后的结果。
3.4.2. 集成静态资源服务 (--static):API 与 UI 的一站式服务
场景分析
设想一个场景:你需要快速验证一个非常简单的 UI 原型,可能只有一个 index.html 文件和几行原生的 JavaScript。为了让这个页面能请求到 json-server 的 API,你通常需要:
- 终端一:运行
pnpm run mock启动 API 服务。 - 终端二:通过
Vite或其他live-server工具启动一个静态文件服务来托管你的index.html。
这不仅繁琐,而且还可能遇到跨域问题。
解决方案JSON Server 可以通过 --static 命令行参数,摇身一变,成为一个同时能提供 API 服务和静态文件服务的“二合一”服务器。
实战用法
在你的项目根目录下,创建一个
public文件夹。1
mkdir public
在
public文件夹中创建一个index.html文件。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
<html lang="en">
<head>
<title>JSON Server Demo</title>
</head>
<body>
<h1>文章列表</h1>
<ul id="posts-list"></ul>
<script>
// 直接请求同源下的 API
fetch('/api/v1/posts?_limit=5')
.then(response => response.json())
.then(posts => {
const list = document.getElementById('posts-list');
list.innerHTML = posts.map(p => `<li>${p.title}</li>`).join('');
});
</script>
</body>
</html>修改你的
package.json启动命令,添加--static参数。文件路径:
package.json(修改mock脚本)1
2
3
4
5
6
7
8
9{
// ...
"scripts": {
// ...
"mock": "json-server generate-data.cjs --routes routes.json --port 3001 --static ./public",
// ...
},
// ...
}重启
pnpm run mock服务。
现在,你只需一个终端。访问 http://localhost:3001/,你将看到 index.html 的页面内容;同时,页面中的 fetch('/api/v1/posts') 请求也能成功获取到 API 数据,因为它们现在是同源的。
3.4.3. 远程数据源:让数据源走向云端
协作场景
在团队协作中,Mock 数据的“唯一事实来源 (Single Source of Truth)”可能不是你本地的一个文件,而是一个由后端同事维护、托管在公司内部网络或 GitHub Gist 上的 JSON 文件链接。
解决方案JSON Server 的数据源参数不仅可以接受本地文件路径,还可以直接接受一个 URL。
用法示例
假设 https://jsonplaceholder.typicode.com/db 是一个公开的、包含 posts, comments 等资源的 JSON 文件 URL。你可以直接这样启动服务:
1 | json-server https://jsonplaceholder.typicode.com/db |
JSON Server 会在启动时下载这个 URL 的内容,并将其作为内存数据库。这使得团队成员之间共享和同步 Mock 数据变得异常简单——只需要共享一个 URL 即可。
第四章:终极武器 · 以专业架构集成 JSON Server
摘要: JSON Server 的声明式配置虽然强大,但终有其能力边界。当我们需要模拟非标准 RESTful 行为、权限校验、或自定义响应结构时,就需要祭出终极武器——将 JSON Server 作为一个标准的 Node.js 模块,在 Express.js 的生态中赋予其无限的扩展能力。本章,你将学会如何通过编写中间件,为你的 Mock API 注入任意自定义逻辑,将其从一个“数据模拟器”升级为一个真正意义上的**“后端行为模拟器”**。
本章地图
4.1. 声明式配置的边界: 明确“为什么”我们需要以编程方式扩展 JSON Server。
4.2. 基础设置:专业的 API 命名空间: 学习以“路由挂载”的最佳实践来启动服务,从源头规范 API 路径。
4.3. 实战核心:中间件与请求体处理: 掌握 Express 中间件的核心概念,并学会处理 POST/PUT 请求的必备工具 bodyParser。
4.4. 实战进阶:模拟权限校验: 编写一个真实世界的权限校验中间件,模拟受保护的 API。
4.5. 终极美化:自定义响应结构: 学习重写 router.render 方法,将所有 API 响应统一包裹成企业级格式。
4.6. 高级技巧:动态路由重写: 探索 jsonServer.rewriter,实现比 routes.json 更强大、更灵活的路由映射。
4.1. 声明式配置的边界
db.json 和 routes.json 让我们能用极低的成本,覆盖约 80% 的标准 REST API 模拟场景。但剩下的 20% 复杂场景,则超出了它们的能力范围,例如:
- 复杂的业务校验: 如何模拟“创建用户时,用户名不能重复”?
- 非 RESTful 端口: 如何模拟一个
POST /login接口,它接收用户名密码,并返回一个token? - 权限控制: 如何模拟“只有管理员角色才能
DELETE文章”? - 动态响应: 如何模拟一定概率下出现的
500服务器错误,以测试前端的容错能力?
要解决这些问题,我们必须跳出 CLI 的便捷框架,进入一个更强大、更灵活的世界——将 JSON Server 作为我们自己 Node.js 应用中的一个模块来使用。
4.2. 基础设置:专业的 API 命名空间
在真实项目中,所有 API 几乎都会被组织在一个统一的命名空间下,例如 /api/v1/。这样做可以清晰地将 API 与其他资源(如页面、静态文件)区分开,也便于未来进行版本管理。
与其使用 routes.json 做简单的路径替换,更专业、更具扩展性的方式是路由挂载 (Router Mounting)。
第一步:创建 server.cjs
在项目根目录创建一个 server.cjs 文件。我们使用 .cjs 扩展名是为了确保 Node.js 能以 CommonJS 规范正确加载它,这是最直接的方式。
文件路径: server.cjs (新增)
1 | // 1. 引入所需库 |
第二步:更新前端服务层
因为所有 API 路径现在都带上了 /api 前缀,我们需要更新 apiClient 的 baseURL 来匹配。
文件路径: src/api/apiClient.ts (修改)
1 | import axios from 'axios'; |
第三步:更新启动命令
文件路径: package.json (新增 mock:pro 脚本)
1 | { |
现在,运行 pnpm run mock:pro。你的 Mock API 服务就以一种更专业的方式启动了。访问 http://localhost:3001/api/posts 将会成功获取数据,而访问 http://localhost:3001/posts 则会返回 404 Not Found。这种清晰的隔离是健壮架构的标志。
4.3. 实战核心:中间件与请求体处理
Express 中间件是一个 (req, res, next) 函数,它像生产线上的工序一样,对流入的请求进行一步步地加工处理。
在添加我们自己的“工序”之前,必须先安装一个关键的设备:请求体解析器 (Body Parser)。
前置知识: 对于自定义的 POST, PUT, PATCH 路由,你需要 req.body 来获取客户端发送的数据。但默认情况下,req.body 是 undefined。你需要一个中间件来读取请求流并将其解析为 JavaScript 对象。
JSON Server 已经内置了这个工具,我们只需启用它。
我们的目标: 启用 bodyParser,并编写第一个中间件,为所有 POST 请求自动添加 createdAt 时间戳。
文件路径: server.cjs (修改)
1 | // ... require, create, defaults, router ... |
重启 mock:pro 服务,现在每当你通过前端应用创建一个新帖子,检查返回的数据或 /db 快照,都会发现它自动包含了 createdAt 字段。
4.4. 实战进阶:模拟权限校验
这是一个极其常见的场景:模拟需要登录凭证才能访问的受保护路由。
我们的目标: 保护所有“写”操作 (POST, PUT, PATCH, DELETE),要求请求头中必须包含 Authorization: Bearer my-secret-token。
文件路径: server.cjs (在时间戳中间件之后,路由挂载之前添加)
1 | // ... (之前的代码) ... |
重启服务后,任何不带正确 Authorization 头的写操作都将被拒绝,并收到 401 错误,完美模拟了受保护的 API 行为。你需要在前端的 apiClient.ts 中通过拦截器或在单个请求中添加此请求头来通过验证。
4.5. 终极美化:自定义响应结构
真实后端的 API 响应,通常会有一个统一的包裹结构,例如 { code, data, msg }。这便于前端进行统一的响应处理。
我们的目标: 将所有成功的 API 响应,从 [...] 或 {...} 格式,统一修改为 { code: 200, data: [...], message: 'Success' } 格式。
文件路径: server.cjs (在路由挂载之后添加)
1 | // ... (之前的代码) ... |
重启服务,现在访问 http://localhost:3001/api/posts,你得到的将不再是原始的数组,而是经过我们精心包装后的、更具真实感的统一响应结构。
4.6. 高级技巧:动态路由重写
routes.json 是静态的,而 jsonServer.rewriter() 允许你用编程逻辑来动态地重写路由,它比路由挂载更精细,比 routes.json 更灵活。
对比:
- 路由挂载 (
server.use('/api', router)): 适用于全局添加前缀,进行命名空间隔离。 - 路由重写 (
rewriter): 适用于个别路径的转换、美化或动态映射。
我们的目标: 将 GET /api/articles?id=1 这样的“丑陋”路径,重写为 JSON Server 能理解的 GET /api/posts/1。
文件路径: server.cjs (在默认中间件之后,bodyParser 之前添加)
1 | // ... |
现在,即使你的前端代码请求的是 /api/articles/1,rewriter 也会在请求到达 router 之前,悄无声息地将其转换为 /api/posts/1,从而获取到正确的数据。这在适配那些路径设计不完全符合 RESTful 规范的旧 API 时尤其有用。
第五章:部署、监控与实用配置
摘要: 恭喜你,已经来到了我们课程的最后一站。在这里,我们将完成从“开发者”到“架构师”的思维跃迁。本地的模拟终究是第一步,一个专业的工程师需要考虑的是:如何让模拟环境更贴近真实世界?如何管理复杂的配置?如何将 Mock API 融入团队协作与自动化流程中?本章,我们将为你补完这至关重要的“最后一公里”,学习部署、监控和进行工业级的专业配置。
5.1. 模拟真实世界:网络延迟与只读模式
在本地开发时,API 请求几乎是瞬时完成的。这种理想环境会掩盖大量在真实网络环境下才会暴露的问题,例如 UI 的 Loading 状态是否健壮、是否处理了重复提交等竞态条件。为了解决这些问题,我们需要人为地制造“真实感”。
JSON Server 提供了两个强大的参数来模拟这些真实世界的限制:
网络延迟 (
--delay,-d)这个参数会为每一个 API 响应人为地增加一段延迟,对于测试应用的 UI 健壮性至关重要。
你可以这样在命令行中使用它:
1
2
3# 让每个 API 请求都延迟 800毫秒 后再返回
# 注意:如果 package.json 脚本中已有参数,需要用 -- 分隔
pnpm run mock -- --delay 800启动这个模式后,再去体验你的应用,就能够清晰地检验 Loading 动画、骨架屏以及各种请求状态下的 UI 表现。
只读模式 (
--read-only,--ro)这个参数会禁用所有的“写”操作(
POST,PUT,PATCH,DELETE),让你的 API 变为一个只读的数据源。1
pnpm run mock -- --read-only
当需要将 Mock API 地址分享给他人进行产品演示,或作为公开文档的示例数据源时,只读模式可以确保数据不会被意外修改,提供了一个稳定、安全的数据环境。
5.2. 超越默认:适配异构后端规范
JSON Server 的默认设定非常标准,但真实世界的后端 API 五花八门。当目标后端 API 规范与默认值不同时,我们需要让工具来适应我们,而不是反过来。
自定义主键 (
--id,-i)如果你的后端主键字段名为
_id或uuid,可以使用此参数进行指定:1
2# 指定 _id 作为所有资源的主键字段
pnpm run mock -- --id _id自定义外键后缀 (
--foreignKeySuffix,--fks)如果后端外键字段名为
post_id而不是postId,你可以使用此参数来让_expand等关系查询功能恢复正常:1
2# 指定所有外键都以 _id 结尾
pnpm run mock -- --fks _id
当配置参数越来越多,package.json 中的 scripts 会变得臃肿不堪。专业的做法是使用 json-server.json 配置文件来统一管理所有设置。
在项目根目录创建 json-server.json 文件:
1 | { |
之后,你的 package.json 启动脚本就可以简化为 json-server -c json-server.json generate-data.cjs。这使得配置的管理和团队同步都变得更加专业和高效。
5.3. 走向云端:协作与部署
首先,要实现协作,需要让你的 Mock 服务从本机走向局域网。使用 --host 0.0.0.0 参数启动服务,局域网内的任何设备便可通过你的电脑 IP 地址(如 http://192.168.1.10:3001)访问你的服务,这对于手机真机调试或团队内部协作至关重要。
而将 Mock API 部署到公网,则能满足更广泛的协作需求,其核心价值在于:
- 团队协作: 为 App 端、小程序端、或其他前端同事提供一个 24/7 可用的、稳定的 Mock 环境。
- CI/CD 集成: 在自动化测试流程中(如 Cypress E2E 测试),让测试服务器有一个可依赖的数据源。
- 产品演示: 在没有真实后端的情况下,向客户或产品经理展示一个功能完整的在线原型。
部署方案主要有两种:
现代方案: Vercel / Netlify (Serverless)
这是最符合现代前端技术栈的方案。其核心思路是将
server.cjs改造为一个 Serverless Function。由于JSON Server的server对象本身就是 Express 实例,你只需移除server.listen()部分,直接导出server对象即可。例如,在 Vercel 项目的api/index.js文件中导出server,平台会自动将其部署为可公开访问的 API 服务。
您提的对,光有理论描述确实不够,一个清晰、可执行的代码示例才能真正让概念落地。为这种“现代方案”提供具体代码是完全必要的。
我将为您详细补充这一部分,包括所需的文件结构、代码和配置文件。
5.3.1. 现代方案实战:将 Mock API 部署到 Vercel
Vercel 是一个非常受现代前端开发者欢迎的平台,它可以轻松部署静态网站和 Serverless Functions。我们将利用这个能力来部署 json-server。
第一步:调整项目结构
Vercel 默认会识别项目根目录下的 api 文件夹作为 Serverless Functions 的来源。我们需要创建这个目录,并将我们的服务逻辑和数据文件放进去。
你的项目结构应该看起来像这样:
1 | /json-server-lab |
第二步:编写 Serverless Function (api/index.cjs)
这个文件和我们在第四章中创建的 server.cjs 非常相似,但有一个关键区别:它不监听端口,而是直接导出 server 实例。
文件路径: api/index.cjs (新增或从 server.cjs 复制修改)
1 | const jsonServer = require("json-server"); |
请注意:为了简单起见,这里我们使用静态的 db.json。由于 Serverless 环境是无状态的,“写”操作(POST, PUT)不会被持久保存。因此,部署到 Vercel 的 Mock API 最适合作为只读的数据源。
第三步:配置 Vercel (vercel.json)
这个配置文件是整个部署过程的“交通警察”。它告诉 Vercel 如何处理收到的请求:哪些请求应该交给我们的 API 处理,哪些应该显示我们的前端应用。
文件路径: vercel.json (新增)
1 | { |
配置解读:
builds数组定义了 Vercel 需要构建什么。第一个对象告诉它api/index.cjs是一个 Node.js 服务。第二个对象告诉它如何构建我们的前端应用(运行build命令,并将产物目录dist作为静态网站)。rewrites数组是路由规则。第一条规则说:所有以/api/开头的请求,都转发给我们的api/index.cjs函数处理。第二条规则说:所有其他的请求,都显示index.html,这是单页应用(SPA)的标准配置。
第四步:部署
- 确保你的
package.json中有build命令 ("build": "vite build")。 - 将你的整个项目推送到一个 GitHub/GitLab/Bitbucket 仓库。
- 在 Vercel 官网上,选择“Import Project”,然后选择你的项目仓库。
- Vercel 会自动识别
vercel.json配置,执行构建和部署。
部署成功后,你将获得一个公开的 URL,例如 https://your-project-name.vercel.app。你的 Mock API 将可以通过 https://your-project-name.vercel.app/api/posts 这样的路径被全世界访问。
5.4. 数据状态管理:使用快照进行场景测试
在进行端到端(E2E)测试时,最大的挑战之一就是保证数据的可预测性。--snapshots (或 -S) 参数为此提供了完美的解决方案。
开启此功能后,每次你进行“写”操作,json-server 都会在项目根目录的 snapshots 文件夹中,自动保存一份当前数据库的完整快照。
这带来了一种专业的测试工作流:
- 准备基线数据: 启动服务,通过 API 调用或手动修改
db.json,构造出你需要的第一个测试场景。 - 生成快照: 对 API 发起一次任意的写操作(如
POST一个临时数据再DELETE它),这将触发json-server在snapshots目录生成一份当前的数据库快照.json文件。 - 命名场景: 将这份快照重命名为有意义的名称,例如
scenario-basic-posts.json。你可以重复此过程,创建所有需要的测试场景快照。 - 在测试中使用: 在你的自动化测试脚本中,可以在测试开始前,通过命令行指定本次
json-server启动时使用哪个快照文件作为数据源。1
2# 在 E2E 测试脚本中,为“空状态测试”启动服务
json-server snapshots/scenario-empty.json
架构师思维: 数据快照功能将你的 Mock API 从一个简单的“模拟器”提升为了一个专业的“测试数据控制器”。它使得状态可复现的自动化测试成为可能,是保障前端应用质量、构建可靠 CI/CD 流水线的关键一环。