Prorise
这是我的博客,分享技术与生活的点点滴滴
前端工程化通关指南:从构建基石到驾驭未来
前端工程化通关指南:从构建基石到驾驭未来
Prorise序章:开启前端工程化之旅——从为何需要到如何学习
摘要: 欢迎来到现代前端开发的世界!如果您是一位刚掌握了 HTML、CSS 和 JavaScript 基础的开发者,您可能会对 Webpack, Vite, NPM, Babel 这些层出不穷的工具感到困惑和不知所措。本序章正是为消除这种迷茫而设。我们将一同探讨为何现代 Web 开发变得如此“复杂”,为您绘制一幅清晰的分阶段学习路线图,并建立一套“问题驱动”的学习心法,帮助您自信地开启这段激动人心的工程化之旅。
0.1. 欢迎来到“施工现场”:为什么我们不能只写 HTML/CSS/JS?
曾几何时,网页开发是一件相对纯粹的事情:一个 .html 文件,链入一个 .css 文件和几个 .js 文件,一个“网页”就诞生了。然而,随着 Web 从简单的“信息展示页面”进化为功能强大的“应用程序”(Web App),我们的开发模式也必须经历一场深刻的革命。
我们面临的挑战是全新的:
- 规模化与协作: 如何将一个庞大的应用拆分成上百个独立的 组件化 单元,并让多人高效地协同开发?
- 代码组织: 如何科学地组织成千上万的 JavaScript 模块化 文件,避免命名冲突和依赖地狱?
- 性能与兼容性: 如何使用最新的 JavaScript 语法(ESNext)提升开发效率,同时又保证代码能在旧款浏览器上平稳运行?如何将上百个资源文件优化、压缩成浏览器最高效加载的形式?
这些挑战,都无法通过简单编写 HTML/CSS/JS 来解决。我们需要一套更强大、更规范的流程和工具,这就是 前端工程化 的由来。它意味着我们将代码的“开发阶段”和最终的“运行阶段”明确分开。我们写的代码是便于自己和团队维护的“源码”,而交给浏览器的,是经过一系列自动化工具处理过的、最优化的“产物”。
而连接“源码”和“产物”的桥梁,就是我们接下来要学习的——前端工具链。
0.2. 建立全局视野:分阶段学习路线图与前置知识建议
面对繁多的工具,最有效的学习方式就是手持一张地图,明确自己的位置和前进的方向。本知识库将遵循一条从基础到前沿的清晰路径,我们强烈建议您按照以下两个阶段进行学习:
第一阶段:前端工程化的通用基石 (第 1 ~ 7 章)
这个阶段的内容,是任何现代前端开发者都必须掌握的通用基础,它不依赖任何特定的前端框架(如Vue/React),只需要您具备扎实的 JavaScript 基础知识即可顺利学习。
- 环境与基础 (第 1-2 章): 我们将学习所有工作的起点——如何在你的电脑上配置一个稳定、灵活的开发环境。
- 依赖管理 (第 3-6 章): 这是工程化的核心。我们将深入
package.json,理解lock文件的契约精神,对比各大包管理工具,并初探企业级的 Monorepo 模式。 - 构建理论 (第 7 章): 我们将通过亲手实践,揭开“构建”的神秘面纱,理解代码是如何被转换、打包和优化的。
学习检查点与建议
在完成第一阶段(前七章)的学习后,我们强烈建议您暂停一下。
后续的章节(特别是第九章 Vite 插件开发)将深入到现代工具链的内部,示例代码会大量使用 TypeScript 和 Node.js 核心API(如 fs, path)。为了获得最佳的学习体验,我们推荐您在继续前,先对这两项技术有一个基本的了解:
- TypeScript: 无需精通,但至少需要能看懂基本的类型注解(如
const name: string)、interface和import type语法。 - Node.js: 无需能开发后端,但需要对
fs(文件读写)、path(路径处理) 等常用内置模块有初步的认知。
您可以将第一阶段的学习视为“必修课”,然后外出“修炼”一下这两项“内功”,再回来挑战更高阶的“进阶课”。
第二阶段:现代构建工具深度实践 (第 8 ~ 10 章)
当您准备好后,就可以进入更高阶的学习。这个阶段我们将深入现代构建工具的核心。
- 温故知新 (第 8 章): 我们会回顾 Webpack 的经典思想,理解其设计哲学与历史局限。
- 核心精通 (第 9 章): 我们将深入掌握现代前端引擎 Vite 的方方面面,从工作原理到插件开发。
- 未来展望 (第 10 章): 最后,我们将一同展望 2025 年及以后的前端工具趋势。
0.3. 核心学习方法:理解每个工具诞生时所要解决的核心“痛点”
最后,请在开始学习前,务必在心中建立一个最重要的思维模型:所有工具的出现,都是为了解决一个特定的问题。
在后续的章节中,我们将始终遵循这一“问题驱动”的模式。对于每一个工具,我们都会先剖析它所要解决的“痛点”,然后再介绍它的解决方案和使用方法。
请始终带着“它解决了什么问题?”的疑问去学习。当你能回答这个问题时,你就真正掌握了这个工具的精髓,而不仅仅是记住了几条命令。
第一章:搭建稳固基石——精通 Node.js 版本管理 (NVM)
摘要: 在我们编写第一行代码之前,一位专业的工程师会先确保自己的“工坊”井然有序。在 Node.js 的世界里,最大的挑战莫过于版本管理:老项目需要旧版 Node.js,新项目却推荐使用最新版。本章将以“保姆级”教程的形式,彻底解决这个“版本冲突”的魔咒。我们将学习如何在 Windows 系统上干净地安装、配置和使用 NVM,为后续所有开发工作建立一个稳定、灵活且可控的环境基础。
在本章中,我们将首先解决所有 Node.js 开发者都会遇到的第一个,也是最棘手的问题——环境管理。我们将按照以下步骤,一劳永逸地解决它:
- 首先,我们将进行 彻底的环境清理,为 NVM 的安装扫清障碍。
- 接着,我们将 图文并茂地安装和配置 nvm-windows,并为其配置国内高速下载源。
- 最后,我们将通过 核心命令实践,熟练掌握多版本 Node.js 的安装、查看与切换,并了解团队协作中的最佳实践。
1.1. 准备工作:彻底卸载已有的 Node.js
在安装 NVM 之前,最重要的一步是确保您的系统中没有其他方式安装的 Node.js 版本,否则会引起严重的冲突。
极其重要:如果你之前是通过 Node.js 官网的 .msi 安装包安装的 Node.js,你 必须 先将它彻底卸载。nvm-windows 无法管理一个已经独立存在的 Node.js 版本。
第一步:通过控制面板卸载
- 打开 Windows 的“控制面板”。
- 进入“程序和功能”。
- 在右上角的搜索框中输入
node。 - 找到
Node.js程序,右键点击,选择“卸载”。
第二步:检查并删除残留文件
卸载程序运行完毕后,请检查以下目录,如果仍然存在,请手动删除它们:
C:\Program Files\nodejsC:\Program Files (x86)\nodejsC:\Users\{你的用户名}\AppData\Roaming\npmC:\Users\{你的用户名}\AppData\Roaming\npm-cache
第三步:清理环境变量
- 右键点击“此电脑” -> “属性” -> “高级系统设置” -> “环境变量”。
- 在“系统变量”和“用户变量”的
Path中,检查是否存在任何与nodejs相关的条目,如果存在,请选中并删除。
1.2. 详解:安装 nvm-windows
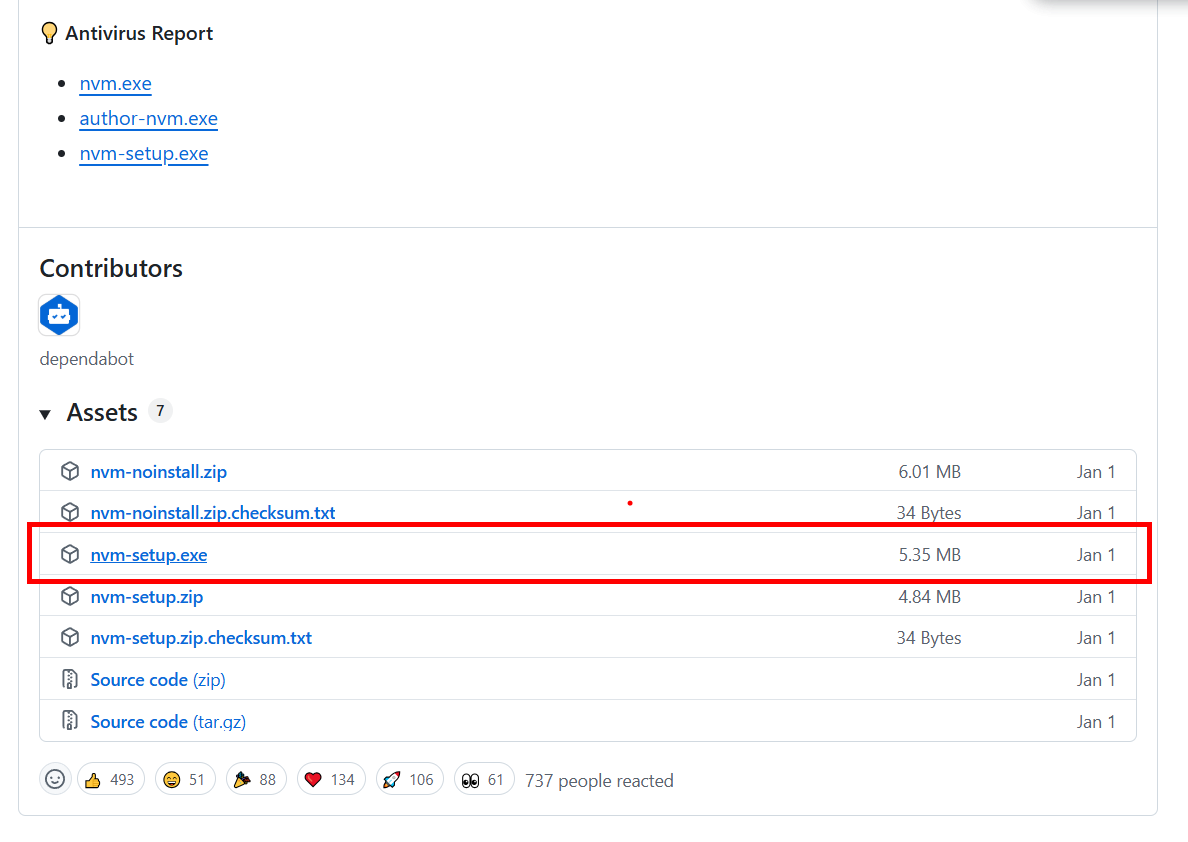
第一步:下载 nvm-windows 安装包
nvm-windows 是一个社区维护的开源项目,我们需要从它的官方 GitHub 仓库下载安装程序。
请选择最新的 nvm-setup.zip 文件进行下载。
第二步:运行安装程序
解压下载的 nvm-setup.zip 文件,双击 nvm-setup.exe 启动安装向导。
第三步:选择 NVM 安装路径
安装程序会要求您选择 NVM 的安装路径。
路径注意:为了避免潜在的权限和编码问题,安装路径中 绝对不能包含中文或空格。推荐使用默认路径或自定义一个简单的英文路径(如 D:\nvm)。
第四步:选择 Node.js 符号链接路径
接下来,程序会要求您选择 Node.js 的符号链接路径。这个路径将作为系统当前激活的 Node.js 的“快捷方式”。同样,确保路径不含中文和空格,推荐使用默认值。
点击“Next”并完成安装。安装程序会自动为您配置好所需的环境变量。
第五步:验证安装
安装完成后,务必重新打开一个新的终端窗口(如 PowerShell 或 CMD),让新的环境变量生效。输入以下命令:
1 | nvm version |
看到版本号即表示 nvm-windows 安装成功!
1.3. 国内用户福利:配置高速下载镜像
默认情况下,NVM 会从国外的 nodejs.org 下载 Node.js,速度可能较慢。我们可以通过修改配置文件,将其指向速度更快的国内镜像。
第一步:找到 settings.txt 文件
在终端输入 nvm root 命令,可以查看到 NVM 的安装路径。
1 | nvm root |
1 | Current Root: C:\Users\YourUser\AppData\Roaming\nvm |
根据显示的路径,找到并打开 settings.txt 文件。
第二步:修改配置文件
在 settings.txt 文件末尾添加以下两行,使用最新的淘宝 NPM 镜像源:
1 | node_mirror: https://npmmirror.com/mirrors/node/ |
保存文件后,NVM 下载 Node.js 的速度将得到极大提升。
1.4. 核心命令实践:安装与切换 Node.js
1. 查看可安装的版本
1 | nvm list available |
该命令会列出所有可供下载的 Node.js 版本。
2. 安装指定版本
我们来安装一个长期支持版(LTS)和一个较新的版本,例如:
1 | nvm install 20.17.0 # 一个稳定的 LTS 版本 |
3. 查看已安装版本
1 | nvm ls |
1 | # 22.5.1 |
星号 * 表示当前终端会话正在使用的版本。
4. 切换使用版本
1 | nvm use 22.5.1 |
验证一下版本是否切换成功:
1 | node -v && npm -v |
版本已成功激活!
1.5. 团队协作的“默契”:.nvmrc 文件的规范化应用
为了保证团队成员使用统一的 Node.js 版本,我们可以在项目根目录下创建一个 .nvmrc 文件,声明项目所需的版本。
文件路径: my-new-project/.nvmrc
1 | 22.5.1 |
当团队成员进入该项目目录后,只需在终端执行 nvm use,即可自动切换到 .nvmrc 文件所指定的版本,极大提升了协作效率。
1.6. 本章核心速查总结
| 分类 | 关键项 | 核心描述 |
|---|---|---|
| 核心概念 | nvm-windows | (推荐) Windows 平台下的 Node.js 版本管理器,通过符号链接实现版本切换。 |
| 重要配置 | .nvmrc | (推荐) 存放在项目根目录,用于声明项目推荐的 Node.js 版本,便于团队协作。 |
| 重要配置 | settings.txt | NVM 的配置文件,可在此添加国内镜像源以加速下载。 |
| 核心命令 | nvm install <版本号> | 下载并安装一个指定版本的 Node.js。 |
| 核心命令 | nvm ls | 列出所有已安装的 Node.js 版本。 |
| 核心命令 | nvm use <版本号> | 在当前终端切换到指定版本的 Node.js。 |
1.7. 高频面试题与陷阱
在你的工作中,如果需要同时维护多个项目,而这些项目依赖的 Node.js 版本各不相同,你会如何处理?
我会使用 NVM,具体在 Windows 上是 nvm-windows。通过它,我可以在电脑上安装多个不同版本的 Node.js,并在不同项目间通过 nvm use 命令快速切换,避免版本冲突。
很好。那为了确保团队所有成员都使用统一的 Node.js 版本进行开发,你有什么好的实践方法吗?
有的。我会在每个项目的根目录下创建一个 .nvmrc 文件,里面写上项目要求的 Node.js 版本号,并把它提交到 Git 仓库。这样,团队成员在进入项目后,只需要执行 nvm use,就可以自动切换到正确的版本,实现了开发环境的标准化。
假如团队成员反映 nvm install 下载 Node.js 特别慢,你会建议如何优化?
我会建议他们配置 NVM 的国内镜像源。具体做法是找到 NVM 安装目录下的 settings.txt 文件,在其中添加 node_mirror 和 npm_mirror 两个字段,指向国内的镜像服务器地址,例如 npmmirror.com 提供的镜像,这样可以极大地提升下载速度。
第二章:项目初始化——理解 NPM 与你的第一个依赖包
摘要: 在上一章,我们已经拥有了一个稳定且灵活的开发环境。现在,是时候踏上从“脚本小子”到“前端工程师”转变的真正第一步了。本章中,我们将揭开一个常见误区:为何前端开发离不开 Node.js?接着,我们会建立起对“包”和“包管理器”这两个核心概念的直观理解。最终,您将亲手完成一次从零到一的项目初始化,成功安装并使用第一个外部依赖包,并初次窥探项目“身份证”——package.json 的奥秘。
在本章中,我们将循序渐进,像建筑师打地基一样,稳固地构建我们的工程化知识体系:
- 首先,我们将澄清 Node.js 在前端开发中的真实角色,消除您的疑惑。
- 接着,我们将通过类比,轻松理解 包 (Package) 和 NPM 的核心理念。
- 最后,我们将进行一次 完整的动手实践,让理论知识落地生根,并为您揭开下一章的核心——
package.json。
2.1. Node.js:现代前端开发的幕后基石
许多初学者在接触 Vue 或 React 等现代框架时,都会遇到第一个门槛:被要求先在电脑上安装 Node.js。这自然会引发疑问,因为 Node.js 广为人知的是其作为服务器端运行时的角色。
实际上,在前端工程化的领域里,Node.js 扮演的是一个“幕后英雄”的角色。我们依赖它,并非是要用它编写网站的后端服务,而是要利用其提供的强大 开发生态系统。它如同一个现代化的厨房,为我们前端开发者(大厨)提供了高效烹饪(构建应用)所需的一切工具。
具体来说,Node.js 为前端开发提供了三大核心能力:
- 1. 包管理能力: Node.js 自带了
npm(Node Package Manager),这是全球最大的软件库。有了它,我们可以轻松地一键下载、管理项目需要的所有第三方代码库(例如React,axios等)。 - 2. 构建工具运行环境: 现代前端开发离不开各种能让我们代码变得更强大的工具(如
Vite,Webpack)。这些工具本身就是用 JavaScript 编写的程序,它们需要在 Node.js 这个“运行时环境”中才能执行。 - 3. 本地开发服务器: 在开发过程中,我们需要一个本地的 Web 服务器来预览我们的应用。Node.js 生态中的工具(如
Vite)可以快速启动一个功能强大的开发服务器,支持热更新等高级功能。
关键认知: 我们需要区分两种 Node.js 的角色。一种是作为 服务器运行时,用于承载网站的后端服务;另一种是作为 本地开发环境时,用于驱动我们的各种开发工具。我们前端开发者关注的是后者。
2.2. 模块化开发的基石:理解“包”与“包管理器”
在过去,向项目中添加一个第三方库(如 jQuery)通常意味着手动下载 .js 文件、复制粘贴、然后通过 <script> 标签引入。这个过程不仅繁琐,在库版本更新时更是一场灾难。
为了解决这一原始的协作方式,社区引入了 包 (Package) 和 包管理器 (Package Manager) 的概念,奠定了现代模块化开发的基础。
包 (Package): 一个“包”是为解决特定问题而封装好的代码集合。它可以是一个 UI 组件库(如 Ant Design),一个工具函数库(如 Lodash),或是一个完整的框架(如 Vue)。您可以把它想象成一块功能明确的“乐高积-木”,具备开箱即用的能力。
包管理器 (Package Manager): 它是管理这些“乐高积木”的智能工具。其核心职责包括:
- 依赖解析: 知道去哪里(通常是 NPM Registry,全球最大的“乐高仓库”)找到你需要的包。
- 下载与安装: 能将你指定的包及其所有依赖(依赖的依赖)一次性、自动化地下载到项目中。
- 版本控制: 记录每个包的精确版本,确保团队成员和生产环境的依赖一致性。
- 生命周期管理: 提供更新、卸载等一系列管理命令。
2.3. 第一次实践:初始化项目与安装依赖
理论介绍完毕,现在让我们亲手实践。我们将从零开始创建一个项目,并安装 lodash 这个强大的工具库。
目标文件结构预览:
1 | # 操作前,你只有一个空文件夹 |
1. 创建并进入项目目录
打开你的终端(推荐在 Windows 上使用 PowerShell 或 Windows Terminal),执行以下命令:
1 | # 创建一个名为 my-first-node-project 的文件夹 |
2. 初始化项目,生成 package.json
执行 npm init 命令来创建 package.json 文件。这个文件是项目的“身份证”,记录着项目名称、版本、依赖等元信息。使用 -y 参数可以跳过问答环节,快速生成默认配置。
1 | npm init -y |
执行后,你的 package.json 文件内容会类似于:
1 | { |
3. 安装依赖包
现在,我们来安装 lodash。它是一个非常流行的 JavaScript 工具库,提供了大量便捷的函数。
1 | npm install lodash |
命令执行完毕后,你会发现文件夹里新增了 node_modules 目录和 package-lock.json 文件。同时,package.json 文件也被自动更新,增加了一个 dependencies 字段:
1 | { |
4. 编写并运行代码
在 my-first-node-project 文件夹中,创建一个名为 index.js 的新文件,并输入以下内容。我们将使用 lodash 里的 chunk 方法,它可以将一个数组按指定大小进行分割。
文件路径: my-first-node-project/index.js
1 | // 1. 在 Node.js 环境中,使用 require 语法引入我们安装的 lodash 包 |
在终端中执行以下命令来运行这个文件:
1 | node index.js |
5. 查看结果
1 | 原始数组: [ 1, 2, 3, 4, 5, 6, 7, 8 ] |
恭喜你! 你已经成功地创建了一个标准化的 Node.js 项目,并利用 NPM 安装和使用了第三方代码库。这是你迈向现代前端工程化的第一步,也是最重要的一步。
2.4. 悬念:package.json 的深度世界
你已经成功地运行了你的第一个 Node.js 项目。在这个过程中,package.json 文件被创建和修改,它像一个安静的管家,默默记录着一切。
我们已经看到了 name, version, 和 dependencies 字段。但是,这个文件远比表面看起来的要强大得多。
scripts字段里那句"test": "..."是什么意思?我们如何用它来自动化我们的工作流?dependencies旁边是否还有其他的dependencies?比如传说中的devDependencies?它们有何区别?- 这个文件还能定义项目的入口、作者、开源协议等等,它们又分别在何时起作用?
package-lock.json这个更复杂的文件又是做什么的?为什么它如此重要?
预告: 在下一章,我们将从一个 package.json 的“使用者”转变为“掌控者”。我们将逐行解剖这个项目的核心配置文件,深度解读每个关键字段的含义与最佳实践,让你真正理解现代化项目的“灵魂”所在。
2.5. 本章核心速查总结
| 分类 | 关键项 | 核心描述 |
|---|---|---|
| 核心概念 | Node.js for Frontend | 作为前端 开发环境,提供包管理、工具运行和本地服务器能力。 |
| 核心概念 | Package (包) | 一组封装好的、可复用的代码,用于解决特定问题。 |
| 核心概念 | NPM | Node.js 的官方 包管理器,用于下载、管理和发布包。 |
| 核心命令 | npm init -y | (常用) 在当前目录快速生成一个默认的 package.json 文件。 |
| 核心命令 | npm install <包名> | (常用) 下载指定的包并将其保存到 dependencies。 |
| 核心命令 | node <文件名> | (常用) 在 Node.js 环境中执行指定的 JavaScript 文件。 |
2.6. 高频面试题与陷阱
很高兴看到你对前端工程化有初步的了解。那你能谈谈,为什么前端开发需要 Node.js 吗?它在我们的工作中具体扮演了什么角色?
您好,前端开发需要 Node.js 并不是用它来写业务服务器,而是把它当作一个强大的开发环境。它主要提供了三个核心能力:首先,它自带的 NPM 包管理器,可以让我们方便地管理项目依赖;其次,像 Vite、Webpack 这些前端构建工具本身是 Node 程序,需要 Node 环境来运行;最后,它还能帮我们快速启动本地开发服务器。
说得很好。那在使用 npm install 时,你有没有注意过 dependencies 和 devDependencies 的区别?它们分别应该用来放什么样的依赖?
有的。dependencies 存放的是项目在生产环境运行时必须的包,比如 React 框架本身或者 axios 库。而 devDependencies 存放的是只在开发阶段需要的包,比如代码检查工具 ESLint、构建工具 Vite 或者测试框架 Jest。这些包在项目打包上线后是不需要的。
第三章:从配置到执行—— package.json 深度解析与命令行工具开发
摘要: 告别枯燥的字段罗列!在本章,我们将扮演一名工具开发者,从零开始构建一个实用的命令行天气查询应用(weather-cli)。在这个旅程中,package.json 将不再是一份静态的配置文件,而是我们手中动态的“项目控制中心”。我们将通过解决真实需求来学习依赖划分、通过模拟线上事故来理解版本控制的深意、并通过构建自动化工作流来释放 scripts 的真正威力。完成本章,您将获得驾驭任何 Node.js 项目核心配置的自信。
3.1. 项目启动:从一个目标开始
我们的目标是创建一个简单的命令行工具:在终端输入命令,就能看到当前城市的天气。让我们从初始化项目开始。
1 | mkdir weather-cli && cd weather-cli |
我们得到了一个初始的 package.json,它将伴随我们整个开发过程。
3.2. 功能实现:dependencies 与 devDependencies 的天壤之别
3.2.1. 引入核心功能:dependencies
要查询天气,我们首先需要能发送网络请求。axios 是一个广受欢迎的 HTTP 客户端库。因为 我们的工具在运行时必须依赖它来获取数据,所以它是一个典型的 生产依赖 (dependencies)。
1 | npm install axios |
同时,为了让命令行输出更美观,我们引入 chalk 库来给文字添加颜色。同样,美化输出是工具核心功能的一部分,因此它也是 dependencies。
1 | npm install chalk@4 # chalk v5+ 是纯 ESM 包,为保持 CommonJS 教程一致性,我们使用 v4 |
现在,package.json 看起来是这样:
1 | "dependencies": { |
让我们编写核心代码 index.js 来使用它们:
文件路径: weather-cli/index.js
1 | const axios = require('axios'); |
现在运行它:
1 | node index.js |
1
2
3
4
今日详情:
温度范围: 低温 23℃ ~ 高温 29℃
风向风力: 东南风 2级
日期: 30
3.2.2. 优化开发体验:devDependencies
我们的核心功能已经完成。但作为工程师,我们还希望代码风格统一、开发流程更顺畅。
- 代码格式化: 我们引入
prettier来自动格式化代码。prettier只在开发阶段 对源码进行格式化,最终用户运行的代码里并不需要它。 - 自动重启: 我们引入
nodemon,它能监听文件变化并自动重启应用,省去手动Ctrl+C和node index.js的麻烦。nodemon也只在开发阶段 使用。
因此,它们都是典型的 开发依赖 (devDependencies)。
1 | npm install prettier nodemon --save-dev |
现在,package.json 完整了:
1 | "dependencies": { |
场景化总结: 请记住这个判断标准——如果你的代码在 index.js 中 require 或 import 了某个包,那它几乎总是 dependencies。如果一个包只通过 npm scripts 调用,或者只用于测试和构建,那它几乎总是 devDependencies。
3.3. 一个“线上事故”:具象化理解 SemVer (^ ~)
我们的 weather-cli v1.0.0 开发完成,axios 的版本是 ^1.11.0。一切看起来很完美。
事故模拟:
一个月后,axios 发布了 1.12.0 版本。这个版本有一个微小的、不兼容的 API 变更(这在现实中不应发生,但我们以此为例),导致错误处理的方式变了。
- 你 (开发者 A): 你的
node_modules里的axios还是1.11.0,一切正常。 - 新同事 (开发者 B): 他今天刚加入项目,执行
npm install。因为版本号是^1.11.0,npm 为他安装了最新的1.12.0版本。 - 结果: 在处理网络异常时,新同事的
weather-cli崩溃了,而你的却安然无恙。“在我这儿是好的啊!” 的经典场景再次上演。
这就是版本号中 ^ (Caret) 符号的威力与风险。它带来了自动获取 bug 修复和新特性的便利,也带来了潜在的不稳定性。
| 符号 | 示例 | 描述 |
|---|---|---|
^ (Caret) | ^1.11.0 | (默认) 拥抱创新:信任此包的次版本更新不会搞破坏。适用于生态成熟、遵循 SemVer 规范的包。 |
~ (Tilde) | ~1.11.0 | 谨慎更新:只接受修订号(bug 修复)的更新,不接受新功能。适用于对稳定性要求极高的核心依赖。 |
| 无符号 | 1.11.0 | 绝对锁定:完全禁止 npm 自动更新此包。适用于一些已知有问题的、或需要保持特定版本的包。 |
如何彻底解决这种不确定性?这正是我们下一章要学习的 package-lock.json 文件的核心使命。它会为整个团队锁定每一个包的精确版本。
3.4. 自动化工作流:释放 scripts 的真正威力
现在,让我们利用 devDependencies 来为 weather-cli 创建一套专业的 scripts 工作流。
修改 package.json 的 scripts 字段:
1 | "scripts": { |
"start": "node index.js": 定义了项目的标准启动方式,用于生产环境或直接执行。"dev": "nodemon index.js": 定义了开发模式。nodemon会在这里大显身手。当你修改并保存index.js时,它会自动重启应用。"format": "prettier --write .": 定义了一个代码格式化命令。--write .表示让prettier格式化当前目录下的所有支持文件。
揭秘 npm run 的魔法:
你可能会问,我没有全局安装 nodemon 和 prettier,为什么 npm run 能找到它们?
原理: 当执行 npm run <脚本名> 时,npm 会自动将 ./node_modules/.bin 目录临时添加到系统 PATH 中。所有通过 npm 安装的可执行包(如 nodemon, prettier)的启动脚本都存放在这里,因此 npm 可以直接调用它们,避免了全局安装污染。
现在,你可以这样工作:
- 开始开发: 运行
npm run dev,然后随意修改index.js的代码,终端会自动刷新。 - 提交代码前: 运行
npm run format,确保代码风格整洁统一。
3. 最终执行: 运行npm start来查看最终效果。
3.5. 从开发到部署:一个 CLI 工具的完整生命周期
我们已经开发出了 weather-cli 的核心功能,但要让它成为一个能 在任何终端直接通过命令执行 的专业工具,还需要经历本地测试、发布、安装等一系列关键流程。
3.5.1. 功能与执行力升级
第一步:代码升级,接收命令行参数
我们首先采纳您提供的更强大的 index.js 版本。它能通过 process.argv 接收用户输入的城市名,并使用了更真实的 API。
第二步:让脚本“可执行”:不可或缺的 Shebang
这是让一个 .js 文件从“普通脚本”蜕变为“可执行命令”最关键的一步。我们必须在 index.js 文件的 最顶端 添加一行特殊的注释:
#!/usr/bin/env node
- 它是什么? 这行代码被称为 Shebang 或 Hashbang。
- 它做什么? 它告诉操作系统(Linux, macOS, 以及 Windows 上的 Git Bash/WSL 等环境),当直接执行这个文件时,应该使用哪个解释器来运行它。
#!/usr/bin/env node的意思是:“请在当前用户的环境变量PATH中找到node程序,并用它来执行我下面的代码。” - 没有它会怎样? 如果没有这一行,当用户在终端输入
weather时,操作系统不知道这是一个 Node.js 脚本,可能会尝试用默认的 shell 解释器来执行,从而导致语法错误或执行失败。
Windows 环境下的特殊说明: 严格来说,在 Windows 的原生 CMD 或 PowerShell 中,Shebang 并不直接生效。但 npm 在执行 npm link 或全局安装时,会非常智能地为我们创建一个 .cmd 的“垫片”文件,这个文件会负责调用 Node.js 来执行我们的脚本。尽管如此,添加 Shebang 依然是开发跨平台 CLI 工具的黄金标准和最佳实践,我们必须遵守。
现在,让我们整合代码和 Shebang:
文件路径: weather-cli/index.js (请更新为以下最终代码)
1 |
|
3.5.2. 本地测试:npm link 的妙用
在发布到 NPM 之前,我们如何在本地模拟一个真实的用户使用场景,直接测试 weather 命令呢?答案就是 npm link。它能在你的电脑上创建一个指向你项目源文件的“全局快捷方式命令”。
第一步:配置 bin 字段
修改 package.json,添加 bin 字段:
1 | { |
第二步:执行链接
在你的项目根目录 (weather-cli/) 下,执行:
1 | npm link |
1
added 1 package in 1s
第三步:全局测试
现在,打开任何一个新的终端窗口,你都可以像使用一个真正的全局命令一样使用 weather 了!
1 | weather 深圳 |
1
2
3
4
5
6
7
城市: 广东 - 深圳
当前温度: 30°C
天气状况: 阵雨
湿度: 91%
空气质量: 优
更新时间: 2025-08-30T10:49:15
今日详情: 低温 26℃ ~ 高温 31℃, 无持续风向 1级
第四步:取消链接
当你本地测试完成,准备发布时,可以取消这个链接:
1 | npm unlink |
3.5.3. 走向世界:发布、安装与卸载
当本地测试万无一失后,我们就可以将它发布到 NPM 仓库,让所有人使用。
第一步:发布包 (模拟)
注意: 发布需要一个 NPM 账号,并通过 npm login 登录。为避免污染公共仓库,我们在此只演示命令,请不要实际执行 npm publish。你需要确保 package.json 中的 name 是一个未被占用的名称。
1 | # 登录 NPM 账号 (需要提前在官网注册) |
第二步:全局安装你自己的包
一旦发布成功,你和其他用户就可以通过 -g (global) 参数来全局安装这个工具了。
1 | npm install -g weather-cli-prorise-demo |
第三步:在任何地方使用
安装完成后,你就可以在电脑的任何路径下使用 weather 命令。
1 | weather 广州 |
1
2
3
4
5
6
7
城市: 广东 - 广州
当前温度: 31°C
天气状况: 多云
湿度: 88%
空气质量: 良
更新时间: 2025-08-30T10:49:15
今日详情: 低温 26℃ ~ 高温 33℃, 无持续风向 2级
第四步:卸载全局包
如果不再需要这个工具,可以轻松地全局卸载它。
1 | npm uninstall -g weather-cli-prorise-demo |
卸载后,weather 命令将不再可用。
3.6. 本章核心速查总结
| 分类 | 关键项 | 核心描述 |
|---|---|---|
| 核心概念 | Shebang | #!/usr/bin/env node,放在 JS 文件首行,使其 可被直接执行。 |
| 发布字段 | bin | (CLI 必备) 将包内可执行文件映射为系统命令,与 Shebang 配合使用。 |
| 核心命令 | npm link | (CLI 开发必备) 在本地创建全局命令用于测试,极大提升开发效率。 |
| 核心命令 | npm install -g <包名> | 全局安装一个包,通常用于安装命令行工具。 |
| 核心命令 | npm uninstall -g <包名> | 全局卸载一个包。 |
| Node.js API | process.argv | 获取命令行参数的数组,[2] 是第一个用户输入的参数。 |
3.7. 高频面试题与陷阱
在开发一个像 weather-cli 这样的命令行工具时,为了让它能被系统直接调用,需要在 package.json 和入口 JS 文件中做什么关键配置?
需要两步关键配置。第一,在 package.json 中设置 bin 字段,将我想暴露的命令(如 “weather”)映射到我的入口 JS 文件(如 “./index.js”)。第二,也是最关键的,我必须在 index.js 文件的第一行添加 Shebang,即 #!/usr/bin/env node,来告诉操作系统用 Node.js 环境来执行这个脚本文件。
非常准确。那你在开发 weather-cli 的过程中,是如何在发布到 NPM 之前进行高效测试的?
我主要使用 npm link 命令。在项目根目录执行 npm link 后,npm 会根据 bin 字段为我的工具创建一个全局的符号链接命令。这样我就能在系统的任何路径下,像真实用户一样直接调用 weather <城市名> 来测试。我对代码的任何修改都会即时反映出来,无需重复安装或发布,极大地提高了开发和调试的效率。
很好。你在 index.js 中用 process.argv[2] 来获取城市参数,那你知道 process.argv[0] 和 process.argv[1] 分别是什么吗?
知道的。process.argv 是一个包含命令行所有参数的数组。process.argv[0] 通常是 Node.js 的可执行文件路径;process.argv[1] 是当前正在执行的脚本文件的路径;从 process.argv[2] 开始,才是用户传递的实际参数。所以我们用 [2] 来获取第一个用户参数。
第四章:团队协作的“契约”——Lock 文件的确定性力量
摘要: 在上一章的结尾,我们遇到了一个经典的团队协作难题:“在我这儿是好的啊!”。本章,我们将直面这个问题的根源——依赖的不确定性,并引入终极解决方案:package-lock.json 文件。我们将深入剖析这份“依赖快照”的内部结构,阐明为何必须将它提交到版本控制。最后,我们将学习并对比 npm install 与 npm ci,掌握在自动化流程和团队协作中保证依赖绝对一致的专业命令。
4.1. “在我这儿是好的啊!”——依赖不确定性问题的根源
让我们回到上一章那个惊心动魄的事故现场:
- 项目背景: 我们的
weather-cli项目在其package.json中依赖了"axios": "^1.11.0"。 - 事故经过:
- 你(开发者 A)在
axios最新版为1.11.0时创建了项目。 - 一个月后,
axios发布了存在微小兼容性问题的1.12.0版。 - 新同事(开发者 B)克隆项目后,执行
npm install。由于^允许次版本更新,npm 为他安装了1.12.0版。 - 结果,同一个项目,在你的电脑上运行正常,在新同事的电脑上却频繁崩溃。
- 你(开发者 A)在
这个问题的根源,正是 package.json 中版本号的 范围性质。^1.11.0 并没有指定一个精确的版本,而是给出了一个“可接受的范围”。虽然这为我们带来了自动更新小补丁的便利,但也引入了团队成员之间、以及开发环境与生产服务器之间 依赖版本不一致 的巨大风险。
4.2. package-lock.json:为你的项目依赖树拍下“快照”
当你第一次成功执行 npm install 后,npm 会自动在你的项目根目录创建一个 package-lock.json 文件。这个文件,正是解决上述问题的关键。
它详细记录了在生成该文件的那一刻,整个依赖树中每一个包(包括你直接依赖的,和你依赖的包所依赖的子孙包)的:
version: 精确的版本号,没有任何^或~。resolved: 该版本包的实际下载地址。integrity: 一个基于文件内容的哈希值(Checksum),用于确保下载的包未经篡改,保证安全性。
让我们来看一下 weather-cli 项目中 package-lock.json 的一个片段:
1 | "node_modules/axios": { |
观察要点:
- 版本锁定:
axios的版本被精确地记录为1.11.0,而不是^1.11.0。 - 来源锁定:
resolved字段指明了它的确切下载来源。 - 内容锁定:
integrity哈希确保了包的完整性。 - 全树锁定:不仅
axios被锁定,它自己的依赖follow-redirects等也被精确地锁定在了1.15.6版本。
4.3. 为什么 package-lock.json 必须提交到 Git 仓库?
因为 package-lock.json 才是团队依赖环境的“唯一真相来源”。
当 package-lock.json 文件存在时,npm install 的行为会发生改变。它会优先读取 lock 文件,并严格按照其中记录的版本、地址和哈希值去下载和构建 node_modules 目录。package.json 中的 ^ ~ 范围符在此时将被忽略。
- 如果不提交
lock文件:每个团队成员、每台部署服务器在执行npm install时,都会根据自己的package.json重新计算依赖,生成一份 全新的、可能与他人不一致的lock文件和node_modules。这又回到了我们最初的混乱状态。 - 如果提交了
lock文件:所有环境(其他开发者、CI/CD 服务器)在执行npm install时,都会基于这份 共享的、一致的lock文件来构建node_modules。从而保证了从开发到生产,整个团队的依赖环境是 像素级 的完全一致。
最佳实践: 始终将 package-lock.json 文件提交到你的版本控制系统(如 Git)。它和你的源代码一样,是项目可复现性的重要保障。
4.4. 面向 CI/CD 与团队协作的命令:npm ci
我们已经知道,当存在 lock 文件时,npm install 会遵循它。但 npm install 的设计初衷是“安装或更新依赖”,它有时仍会尝试更新 lock 文件(比如你手动修改了 package.json)。在追求绝对一致性的场景下,我们需要一个更严格、更纯粹的命令:npm ci。
ci 是 “Continuous Integration”(持续集成)的缩写,这个命令是专门为自动化环境和确保严格一致性而设计的。
设计哲学
灵活的依赖管理命令。
核心行为
- 检查
node_modules - 比对
package.json与package-lock.json - 若版本兼容,按 lock 文件安装
- 若依赖新增/升级,更新 lock 文件
- 复用本地缓存,增量安装
适用场景
日常开发中 添加、升级、删除 单个依赖
1 | # 添加生产依赖 |
设计哲学
快速、可靠、可复现的构建命令。
核心行为
- 强制存在
package-lock.json - 清空
node_modules,从零开始 - 严格按 lock 文件 安装,忽略
package.json范围 - 若 lock 与 json 不匹配,直接报错退出
- 跳过依赖解析,速度通常比
npm install更快
适用场景
- 首次克隆项目初始化
- CI/CD(GitHub Actions、Jenkins 等)
- 需要 100 % 可复现构建的任何环节
4.5. 本章核心速查总结
| 分类 | 关键项 | 核心描述 |
|---|---|---|
| 核心概念 | package-lock.json | (关键) 项目依赖树的精确快照,保证依赖的确定性,必须提交到 Git。 |
| 核心概念 | Integrity Hash | lock 文件中的哈希值,用于校验包的完整性,防止篡改。 |
| 核心命令 | npm install | (日常开发) 用于添加、更新、删除依赖,可能会更新 lock 文件。 |
| 核心命令 | npm ci | (团队协作/CI 推荐) 快速、纯净地从 lock 文件安装依赖,绝不修改 lock 文件。 |
| 最佳实践 | Git Commit | 始终将 package-lock.json 与 package.json 的修改一并提交。 |
4.6. 高频面试题与陷阱
在团队协作中,package-lock.json 文件起到了什么关键作用?为什么我们强烈推荐将它提交到 Git 仓库?
package-lock.json 文件的关键作用是“锁定依赖”,它记录了项目整个依赖树中每个包的精确版本、下载地址和内容哈希。我们必须将它提交到 Git,因为它是团队成员间、以及开发与生产环境间同步依赖的“唯一真相来源”。有了它,无论谁在何时何地执行 npm install,都能得到一个完全相同的 node_modules 目录,从而根除了“在我这儿是好的啊”这类因环境不一致导致的问题。
非常好。那么 npm install 和 npm ci 这两个命令有什么核心区别?你在什么场景下会选择使用 npm ci?
它们的核心区别在于设计目的。npm install 是一个通用的依赖管理命令,它可能会根据 package.json 的变动去更新 package-lock.json。而 npm ci 是为可复现构建而生的,它有三个严格的特点:首先,它会先删除 node_modules 保证纯净安装;其次,它完全依据 package-lock.json 来安装,绝不会修改它;最后,如果 package.json 和 lock 文件不一致,它会报错退出。因此,我会在两种场景下坚决使用 npm ci:一是新同事克隆项目初始化环境时;二是在所有自动化环境,比如 CI/CD 的流水线中,以确保每次构建都是在绝对一致的依赖下进行的。
第五章:包管理器选型指南——NPM、Yarn 与 PNPM 全方位对比
摘要: 掌握了 lock 文件后,我们已经能确保项目的依赖一致性。但新的问题随之而来:哪个包管理器能提供最快的安装速度、最少的磁盘占用和最规范的依赖管理?本章,我们将深入这场由 NPM、Yarn 和 PNPM 主导的“三国演义”。我们将回顾历史,理解 Yarn 因何而生;然后通过真实的数据评测,见证 PNPM 的“降维打击”;最后,我们将深入 PNPM 的技术内核,理解其高效背后的秘密,并为您献上 2025 年的技术选型终极指南。
5.1. 历史视角:Yarn Classic 为何能挑战 NPM?
在 2016 年前,NPM (v3/v4) 作为唯一的官方包管理器,存在一些广为诟病的痛点,这为 Yarn 的诞生提供了契机。
- 痛点一:安装速度慢: NPM 采用串行方式下载和安装依赖,一个包必须等上一个包安装完成后才能开始,导致整体效率低下。
- 痛点二:依赖不确定 (v4 之前): 早期的 NPM 没有
lock文件的概念,仅靠package.json的版本范围无法保证团队成员安装的依赖版本完全一致,是“在我这儿是好的啊”问题的重灾区。 - 痛点三:命令行输出混乱: 安装过程中的输出信息非常冗长,错误信息常常被淹没在大量的日志中。
正是在这个背景下,Facebook (现 Meta) 推出了 Yarn (Classic),它像一位革命者,精准地解决了上述所有问题:
- 并行安装: Yarn 将依赖解析和下载过程并行化,极大地提升了安装速度。
- 引入
yarn.lock: Yarn 从诞生之初就带来了lock文件机制,保证了依赖的确定性,这也是后来 NPM v5+ 吸收package-lock.json的直接原因。 - 简洁的输出: Yarn 的命令行输出更加简洁、美观,关键信息一目了然。
Yarn 的出现,鲶鱼般地搅动了整个前端生态,迫使 NPM 团队开始正视并解决自身的问题。
5.2. 现代 NPM 的追赶与现状
面对 Yarn 的强力挑战,NPM 团队在 v5 版本后奋起直追:
- 引入
package-lock.json: 正式采纳了lock文件机制,解决了确定性问题。 - 优化缓存与性能: 引入了更完善的缓存机制,并对依赖解析算法进行了优化,使得安装速度有了显著提升。
npx命令: 引入了npx,极大地简化了调用项目本地依赖和试用 NPM 包的流程。
如今的现代 NPM (v7+),在功能和性能上已经基本追平了 Yarn Classic,成为了一个稳定、可靠的官方选择。但就在 NPM 和 Yarn 的“两强争霸”看似尘埃落定时,一位思想完全不同的“颠覆者”登场了。
5.3. PNPM 的“降维打击”:性能与磁盘空间的极致优化
PNPM (Performant NPM) 并没有在 NPM 和 Yarn 的赛道上进行微创新,而是从一个全新的维度——文件系统管理——对 node_modules 的实现方式发起了革命。
让我们通过一个真实的评测,来直观感受它的威力。我们将使用 create-vite 创建一个标准的 React + TypeScript 项目,然后分别用三者来安装依赖。
测试项目初始化:
1 | npm install -g yarn |
评测一:首次安装 (无缓存)
我们分别删除 node_modules 和 lock 文件,然后执行安装命令。
1 | # 使用 NPM |
1
added 268 packages in 25.3s
1 | # 使用 Yarn |
1
Done in 21.8s.
1 | # 使用 PNPM |
1
2
3
4
Packages: +268
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
Progress: resolved 268, reused 0, downloaded 268, added 268, done
Done in 13.5s
评测二:二次安装 (有缓存)
我们再次删除 node_modules,但不删除 lock 文件,再次执行安装。
1 | # 使用 PNPM (二次安装) |
1
2
3
4
Packages: +268
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
Progress: resolved 268, reused 268, downloaded 0, added 268, done
Done in 4.2s
评测三:磁盘空间占用
安装完成后,我们查看 node_modules 目录的大小(结果因系统和版本而异)。
- NPM/Yarn:
node_modules约 280 MB。 - PNPM:
node_modules约 180 MB(实际占用,但通过链接共享了全局文件)。
结论: 无论是在安装速度(尤其是二次安装)还是磁盘空间占用上,PNPM 都表现出了压倒性的优势。这背后的秘密,就在于它独特的 node_modules 管理机制。
5.4. 深入 PNPM 内核:非扁平化结构与符号链接
5.4.1. 幽灵依赖:NPM/Yarn 扁平化结构的副作用
为了解决早期 NPM 版本中因依赖层级过深导致 Windows 路径超长的问题,NPM v3+ 和 Yarn 都采用了“扁平化” 的 node_modules 结构。它们会尝试将所有依赖(包括子孙依赖)都提升到 node_modules 的根目录。
这种结构带来了一个严重的副作用——幽灵依赖。假设你的项目只依赖了 axios,而 axios 依赖了 follow-redirects。在扁平化结构下,follow-redirects 也会被提升到根目录。这意味着,你可以在你的代码中 require('follow-redirects'),即使你从未在 package.json 中声明过它!这是一种非常不规范、且极具风险的行为。
5.4.2. PNPM 的解决方案:链接与全局存储
PNPM 通过两个核心技术彻底解决了上述问题:
内容寻址的全局存储:
PNPM 会在你的主磁盘(如C:\Users\YourUser\.pnpm-store)中创建一个全局仓库。任何版本的任何包,在你的电脑上 只会下载并实体存储一次。**硬链接 与符号链接 **:
- 当你执行
pnpm install时,PNPM 不会复制文件。它会通过 硬链接,将全局仓库中的包文件“映射”到你项目的node_modules/.pnpm目录中。硬链接几乎不占用额外的磁盘空间。
* 然后,它会在node_modules根目录创建 符号链接(类似于快捷方式),指向.pnpm目录中对应的包。
这种结构带来了三大好处:
- 节省空间: 100 个项目依赖同一个版本的
react,在磁盘上也只存一份实体文件。 - 速度极快: 大部分依赖直接从全局仓库链接而来,省去了大量的下载和文件 I/O。
- 杜绝幽灵依赖:
node_modules根目录只会有你在package.json中明确声明的依赖的符号链接。axios的依赖follow-redirects不会出现在根目录,你自然也无法在代码中非法引用它,保证了依赖关系的绝对纯洁。
5.5. 2025 年技术选型指南:我应该选择哪一个?
新项目 (个人或团队)
首选:PNPM
- 理由:极致的性能、巨大的磁盘空间节省、严格的依赖管理,它代表了当前包管理器的最佳实践和未来方向。其内置的
workspace功能对 Monorepo 项目的支持也是一流的。
维护现有项目
原则:遵循项目已有规范
- 如果项目已在使用
NPM和package-lock.json:继续使用 NPM。现代 NPM 稳定且可靠,没有必要为了迁移而迁移。 - 如果项目已在使用
Yarn(尤其是 Yarn v2+ Berry 和 PnP 模式):继续使用 Yarn。Yarn Berry 的 Plug’n’Play 特性提供了一种完全不同的、无node_modules的管理模式,有其独特的优势,应保持一致。
特定受限环境
备选:NPM
- 在某些严格的、无法创建符号链接的企业环境或 CI/CD 平台中,NPM 的传统
node_modules结构可能是更稳妥的选择。
5.6. 本章核心速查总结
| 分类 | 关键项 | 核心描述 |
|---|---|---|
| 核心概念 | 扁平化 (Hoisting) | NPM/Yarn 将子孙依赖提升到 node_modules 根目录的策略。 |
| 核心概念 | 幽灵依赖 | 因扁平化导致可以引用未在 package.json 中声明的包的问题。 |
| PNPM 核心 | 全局内容寻址存储 | 所有包的实体文件在磁盘上只存储一份。 |
| PNPM 核心 | 硬链接/符号链接 | 通过链接而非复制文件的方式构建 node_modules,实现极致的速度和空间优化。 |
| PNPM 优势 | 非扁平化结构 | node_modules 结构与 package.json 严格对应,从根本上杜绝幽灵依赖。 |
| 技术选型 | PNPM | (2025 年推荐) 新项目的首选,性能、空间、规范性全面领先。 |
5.7. 高频面试题与陷阱
你能解释一下什么是“幽灵依赖”吗?它可能会带来什么风险?
“幽灵依赖”是指我的项目代码可以直接 require 或 import 一个我没有在 package.json 中明确声明的包。它产生的原因是像 NPM 和 Yarn 这样的包管理器会把子孙依赖“提升”到 node_modules 的根目录。风险非常大:首先,它让项目的依赖关系变得不明确;其次,如果某个依赖的父包在未来更新时不再依赖这个“幽灵依赖”,我的代码就会在没有任何直接改动的情况下突然崩溃。
很好。那 PNPM 是如何从根本上解决这个问题的?
PNPM 采用的是一种非扁平化的 node_modules 结构。在 node_modules 的根目录,它只为我在 package.json 中直接声明的依赖创建符号链接。而这些依赖自己的子依赖,则被存放在一个隐藏的 .pnpm 目录中,并且是通过符号链接相互关联的。这样,我的项目代码就无法访问到那些没有在 package.json 中声明的子孙依赖,从而从文件结构上根除了幽灵依赖问题。
你提到 PNPM 在速度和磁盘空间上有巨大优势,能简述一下它实现这一点的两个核心技术吗?
当然。它的第一个核心技术是“全局内容寻址存储”。任何版本的包文件,在磁盘上只会有一份实体副本存放在一个全局仓库里。第二个核心技术是“链接机制”。当我在项目中安装依赖时,PNPM 并不会复制这些文件,而是通过硬链接将全局仓库中的文件“映射”到项目的 .pnpm 目录,再通过符号链接将 .pnpm 中的包“快捷方式”放到 node_modules 根目录。这个“只链接,不复制”的策略,使得安装过程几乎只涉及创建链接的 I/O,所以速度极快,并且多个项目可以安全地共享同一份实体文件,极大地节省了磁盘空间。
第六章:大型项目管理术——Monorepo 架构与 PNPM Workspaces 实战
摘要: 当我们的项目从一个独立的“小作坊”成长为由多个包(如组件库、主应用、文档站)构成的“联合企业”时,传统的 Multi-repo(多仓库)管理模式将面临代码复用困难、依赖管理混乱等巨大挑战。本章,我们将学习解决这一问题的现代前端架构模式——Monorepo(单体仓库)。我们将深入对比它与 Multi-repo 的优劣,并以一个真实的设计系统为案例,手把手教你使用 PNPM Workspaces 搭建、管理和维护你自己的第一个 Monorepo 项目。
6.1. 什么是 Monorepo?它与传统的 Multi-repo 有何不同?
在软件开发中,代码仓库的管理方式主要有两种:
- Multi-repo (多仓库): 这是最传统、最常见的方式。每个项目、每个库都有自己独立的 Git 仓库。例如,
webapp在一个仓库,ui-components在另一个仓库。 - Monorepo (单体仓库): 将所有相关的项目、库都放在同一个 Git 仓库中进行管理。例如,
webapp和ui-components都在同一个仓库的不同子目录中。
这两种模式在工作流、代码共享、版本控制等方面有着天壤之别。
| 对比维度 | Multi-repo (多仓库) | Monorepo (单体仓库) |
|---|---|---|
| 代码库管理 | 每个包一个独立的 Git 仓库。 | 所有包共享同一个 Git 仓库。 |
| 代码共享 | 困难。共享代码需发布为 npm 包,本地调试需 npm link,流程繁琐。 | 极其容易。可以直接在仓库内部互相引用,无需发布,修改即时生效。 |
| 依赖管理 | 分散。每个包有自己的 node_modules,易造成依赖版本不一致和冗余。 | 集中。可将公共依赖提升到根目录,统一管理,保证版本一致。 |
| 版本控制 | 分散。每个包独立打版本号。 | 可统一版本,也可独立版本,管理方式更灵活。 |
| 原子化提交 | 不可能。一个跨多包的功能修改,需要向多个仓库提交 commits。 | 核心优势。可以一次 commit 完成跨多包的修改,保持逻辑的原子性。 |
| 构建与 CI/CD | 简单。每个仓库配置独立的 CI 流程。 | 较复杂。需要工具支持来识别变更范围,实现按需构建和测试。 |
| 适用场景 | 互相完全独立的项目。 | 互相之间有代码共享、有强依赖关系的多个项目。 |
6.2. Monorepo 的优势:以“设计系统”为例
为了更具体地感受 Monorepo 的威力,让我们构思一个真实的企业级场景:Acme 公司要构建自己的设计系统。
这个系统至少包含三个包:
@acme/ui-components: 核心的 UI 组件库 (React/Vue)。@acme/docs: 用于展示和测试组件的文档站 (VitePress/Storybook)。@acme/webapp: 使用这套组件库的官方主应用。
在 Multi-repo 模式下,工作流会是这样:
- 修改了
@acme/ui-components里的一个按钮组件。 - 为了在文档站里看效果,需要先将组件库发布一个
beta版本到 npm。 @acme/docs项目更新依赖,安装这个beta版本,然后启动调试。- 调试通过后,再将组件库发布一个正式版。
@acme/webapp和@acme/docs再更新到正式版。这个流程因为涉及多次发布和安装,效率极其低下。
而在 Monorepo 模式下,工作流将变得无比丝滑:
- 直接在 Monorepo 中修改
@acme/ui-components的按钮组件代码。 - 由于
@acme/docs是直接通过源码引用组件库的,它的开发服务器会 立即热更新,实时看到修改效果。 - 调试完成后,进行 一次原子化提交,这个提交同时包含了组件库的修改和(可能有的)文档站的适配修改。
Monorepo 的核心优势在于,通过将所有相关代码集中管理,极大地 降低了跨包协作的成本,让多包开发如同在一个项目中修改不同模块一样简单。
6.3. 实战入门:使用 PNPM Workspaces 搭建你的第一个 Monorepo
PNPM 内置了对 Monorepo(在 PNPM 中称为 Workspaces/工作区)的顶级支持。现在,让我们亲手搭建上面提到的 Acme 设计系统。
第一步:创建 Monorepo 根目录
1 | # 创建并进入项目根目录 |
第二步:定义工作区 (Workspace)
创建 pnpm-workspace.yaml 文件,这是声明此项目为 Monorepo 的“开关”。
文件路径: acme-design-system/pnpm-workspace.yaml
1 | packages: |
第三步:创建子项目
1 | # 创建用于存放所有子项目的目录 |
此时,你的项目结构应该是这样:
1 | # acme-design-system/ |
第四步:安装公共依赖
我们的三个子项目很可能都依赖 react 和 typescript。我们可以把这些公共依赖安装在 Monorepo 的 根目录,让所有子项目共享。
使用 -w 或 --workspace-root 标志来告诉 PNPM 在根目录安装。
1 | # 在 Monorepo 根目录执行 |
执行后,react 等依赖会被安装到根目录的 node_modules 中,并被自动“提升”(hoist),所有子项目都可以直接引用到它们,无需重复安装。
6.4. 依赖管理与内部包的互相引用
这是 Monorepo 最神奇的地方:如何让 @acme/webapp 依赖本地的 @acme/ui-components?
第一步:修改子项目名称
为了能互相引用,我们需要先给子项目 package.json 里的 name 字段赋予规范的、带作用域的名称。
packages/ui-components/package.json->"name": "@acme/ui-components"packages/docs/package.json->"name": "@acme/docs"packages/webapp/package.json->"name": "@acme/webapp"
第二步:使用 workspace:* 协议
现在,我们编辑 webapp 的 package.json,让它依赖 ui-components:
文件路径: packages/webapp/package.json
1 | { |
workspace:* 这个特殊的协议告诉 PNPM:“我依赖的 @acme/ui-components 不是 NPM 仓库里的某个版本,而是 当前工作区中的那个本地包”。
第三步:运行 pnpm install
在 Monorepo 根目录 运行:
1 | pnpm install |
PNPM 会识别到 workspace:* 协议,然后它不会去下载任何东西,而是会在 packages/webapp/node_modules 目录下,创建一个指向 packages/ui-components 目录的 符号链接。
第四步:在子项目中运行脚本
如果你想运行 webapp 的 dev 脚本,可以使用 -F 或 --filter 标志:
1 | # 假设 webapp 的 package.json 中有 "dev": "vite" |
这个命令会精准地只运行指定子项目的脚本,是 Monorepo 开发中的日常操作。
6.5. 本章核心速查总结
| 分类 | 关键项 | 核心描述 |
|---|---|---|
| 核心概念 | Monorepo | 在单一 Git 仓库中管理多个相关联的包,以提升代码复用和协作效率。 |
| 核心概念 | Multi-repo | 每个包拥有独立的 Git 仓库,是传统的、分散式的管理方式。 |
| PNPM 配置 | pnpm-workspace.yaml | (关键) 用于声明一个项目是 PNPM Monorepo 并定义工作区范围的文件。 |
| PNPM 协议 | workspace:* | (核心) 在 package.json 中使用,用于声明一个依赖是工作区内的本地包。 |
| 核心命令 | pnpm add <pkg> -w | 在 Monorepo 根目录 安装一个所有包共享的依赖。 |
| 核心命令 | pnpm --filter <pkg_name> | (常用) 在 Monorepo 中,精准地对指定子项目执行命令(如 dev, build)。 |
6.6. 高频面试题与陷阱
你们为什么选择使用 Monorepo 架构?它主要解决了你们团队的什么问题?
我们选择 Monorepo 主要是为了解决跨项目代码复用的问题。比如我们的主应用、文档站都需要使用同一个内部组件库。在 Monorepo 中,组件库可以直接被其他项目以源码形式引用,任何修改都能即时生效,无需发布 npm 包,极大地提升了开发联调的效率。此外,它还带来了依赖集中管理和原子化提交的好处,保证了所有相关项目技术栈和版本的一致性。
听起来不错。那在 PNPM Workspaces 中,如果我想让 webapp 依赖工作区里的 ui-components,我应该怎么在 package.json 中声明?pnpm install 时会发生什么?
我会在 webapp 的 package.json 的 dependencies 中,将 @acme/ui-components 的版本号指定为 workspace:*。当在 Monorepo 根目录运行 pnpm install 时,PNPM 会解析这个协议,它不会去 npm 仓库下载,而是在 webapp 的 node_modules 目录下创建一个指向 packages/ui-components 源码目录的符号链接。这样就实现了本地包之间的高效引用。
好的。现在 Monorepo 里有几十个包,我只想运行其中一个,比如 @acme/docs 的 build 脚本,应该用什么命令?
我会使用 --filter 标志。在 Monorepo 的根目录执行 pnpm --filter @acme/docs build。这个命令可以让 PNPM 精准地定位到 @acme/docs 这个包,并只在它的上下文中执行 build 脚本,避免了进入特定目录的麻烦,也方便在 CI/CD 流程中进行自动化操作。
第七章:揭秘“构建”过程——代码转换、打包与压缩
摘要: 在前面的章节,我们已经能熟练地使用 require 语法在 Node.js 环境中构建应用。但一个核心问题悬而未决:我们写的这些 Node.js 代码,能直接在浏览器里运行吗?如果我们想使用一些前沿的 JavaScript 新特性,如何保证它在旧环境中也能正常工作?本章,我们将聚焦于解决这些问题的“构建”过程。我们将以 weather-cli 项目为蓝本,探索代码转换、打包和压缩这三大核心任务,理解现代构建工具是如何将我们的“源码”打造成能在任何地方高效运行的“成品”的。
7.1. 我们的目标:让 weather-cli 跑在浏览器上
让我们从一个清晰的目标开始:将我们在前面章节中创建的多文件、使用 CommonJS (require) 语法的 weather-cli Node.js 项目,改造为一个 可以在浏览器 index.html 中引用的、单一的、优化过的 bundle.min.js 文件。
重要信息: 这一章节我们采用手动打包的形式,在前端的发展史中,都是这些小的程序去构建出了一个大的程序,在以后,webpack,以及现在前端最潮流的 vite 打包工具,都能为我们一键操作多个流程
要达成这个目标,我们的源码必须经历一次“进化”,完成三个环节的转换
7.2. 环节一:代码转换
7.2.1. 理论解析
场景: 假设我们想用 ES2020 的新语法——可选链操作符 (?.) 来简化 weather-cli 的代码,以避免因数据结构层级过深而导致的运行时错误。
升级前 (安全但繁琐):
1 | const cityInfo = response.data.cityInfo; |
升级后 (简洁但有兼容风险):
1 | const city = response.data.cityInfo?.city || '未知'; |
这段简洁的代码,在旧版本的浏览器中会直接导致语法错误。为了解决这个问题,我们需要 Babel 这样的“代码翻译官”,将高版本的 JavaScript 语法,转换为功能等价、兼容性更好的旧版语法。
同时,对于新的 函数或方法(如 Array.prototype.flat()),我们还需要 Polyfill(垫片) 来在旧环境中“模拟”出这些 API。
7.2.2. 动手实践:配置并运行 Babel
第一步:安装 Babel 核心依赖
1 | pnpm add @babel/core @babel/cli @babel/preset-env -D |
@babel/core: Babel 的核心引擎。@babel/cli: 提供了从命令行使用 Babel 的能力。@babel/preset-env: 一个智能的“预设包”,能根据目标环境自动确定需要转换哪些新语法。
第二步:配置 Babel
在项目根目录创建 babel.config.js 文件。
文件路径: weather-cli/babel.config.js
1 | module.exports = { |
第三步:组织源码并执行转译
为了规范,新建一个 src 目录,并将 index.js 移动进去。在 package.json 中添加 build:babel 脚本:
1 | "scripts": { |
babel src --out-dir dist 命令意为:将 src 目录下的所有 JS 文件进行转译,输出到 dist 目录。
执行它:
1 | npm run build:babel |
执行后,项目下会生成一个 dist 目录,里面的 .js 文件就是被 Babel 转换过后的兼容性代码。
7.3. 环节二:模块打包
7.3.1. 理论解析
经过 Babel 处理后,dist 目录里的代码虽然语法兼容了,但它们依然是两个独立的文件,并且保留着 require 和 module.exports 语句。浏览器既不认识这种模块语法,也无法接受我们让它发起多个 HTTP 请求去加载这些零散的文件。
打包器 的工作就是解决这个问题。它会从一个入口文件出发,分析 require 语句,绘制出一张“依赖图”,最终将所有必需的模块合并成一个浏览器可执行的大文件 bundle.js。
7.3.2. 动手实践:使用 Browserify 打包
第一步:安装 BrowserifyBrowserify 是一个专注于将 CommonJS 模块打包成浏览器代码的工具,非常适合我们当前的场景。
1 | pnpm add browserify -D |
第二步:添加打包脚本
在 package.json 的 scripts 中添加 build:bundle 脚本:
1 | "scripts": { |
此命令意为:从 dist/index.js 入口开始,分析依赖,然后将它们全部打包进 bundle.js 文件。
重要信息: 注意,由于最新版的 axios 已经完全抛弃了 es5 的语法,我们的需要测试这些底层工具需要手动降级 axios,通过 npm uninstall axios 和 npm install axios@0.27.2 先下载一个旧版本我们才能测试通过
执行它:
1 | npm run build:bundle |
执行后,项目根目录会生成一个 bundle.js 文件。这个文件已经包含了我们所有的代码,并且可以在浏览器中运行。
7.4. 环节三:代码压缩
7.4.1. 理论解析
我们的 bundle.js 文件虽然功能完备,但其中包含了大量的空格、换行和注释,体积较大,会影响线上用户的加载速度。代码压缩 (Minification) 就是构建流程中必不可少的“瘦身”工序。
压缩前:
1 | // 获取城市代码,如果找不到则返回默认值 |
压缩后:
1 | function getCityCode(c){return require("./cities.js")[c]||"101281001"} |
7.4.2. 动手实践:使用 Terser 压缩
第一步:安装 TerserTerser 是一个高效的 JavaScript 压缩器。
1 | pnpm add terser -D |
第二步:添加压缩脚本
在 package.json 中添加 build:minify 脚本:
1 | "scripts": { |
此命令意为:读取 bundle.js,进行压缩和变量名混淆,然后输出到 bundle.min.js 文件。
执行它:
1 | npm run build:minify |
现在,你得到了最终的产物:bundle.min.js。
最后一步:在浏览器中验证
创建一个 index.html 文件来加载我们亲手构建出的 bundle.min.js。
文件路径: weather-cli/index.html
1 |
|
用浏览器打开这个 index.html 文件,然后打开开发者工具的控制台(按 F12),你将看到 weather-cli 成功打印出了天气信息!
恭喜!你已经不再是一个只会“使用”工具的开发者了。你亲手搭建了一个虽然简单但五脏俱全的构建流水线,你现在深刻地理解了那些看似神奇的“黑盒”工具(如 Webpack, Vite)背后,最核心的工作原理。
7.5. 本章核心速查总结
| 分类 | 关键工具/概念 | 核心描述 |
|---|---|---|
| 理论概念 | Transpiling (转译) | 将 新语法 转换为向后兼容的 JS 语法。 |
| 实践工具 | @babel/cli | 提供了 babel 命令,用于执行语法转译。 |
| 理论概念 | Bundling (打包) | 将多个模块文件根据依赖关系合并成一个或少数几个文件。 |
| 实践工具 | browserify | 用于将 CommonJS 模块打包成单个浏览器可执行文件。 |
| 理论概念 | Minification (压缩) | 移除多余字符和混淆变量名,将代码体积压缩到极致。 |
| 实践工具 | terser | 高效的 JS 压缩器,用于生成生产环境代码。 |
7.6. 高频面试题与陷阱
你能解释一下在一个典型的前端构建流程中,“转译(Transpiling)”和“打包(Bundling)”这两个步骤各自解决了什么问题吗?
当然。“转译”主要解决的是 语言兼容性 问题,它通过像 Babel 这样的工具,将开发者使用的高级语法(如 ESNext)转换为绝大多数浏览器都能理解的旧版 JavaScript 语法,但它不处理文件间的依赖关系。而“打包”主要解决的是 模块化和性能 问题,它通过像 Browserify 或 Webpack 这样的工具,解析 require 或 import 语句,将我们拆分成多个文件的项目源码,合并成一个或少数几个文件,以减少浏览器的 HTTP 请求次数,提升加载性能。
第八章:一个时代的印记——回溯 Webpack,理解下一代构建工具的基石
摘要: 在 Vite 的光芒照耀前端开发领域的今天,我们有必要回望那个曾经定义了“前端工程化”的巨人——Webpack。它并非是需要被淘汰的过时技术,而是一座丰碑。理解了 Webpack 的崛起、辉煌以及它面临的挑战,你才能真正领会 Vite 所带来的“革命”究竟革新了什么。本章,我们将不纠结于繁琐的配置,而是站在历史的高度,重新审视 Webpack。
8.1. 混沌初开:Webpack 诞生前的“前端江湖”
在 Webpack 出现之前,前端开发更像是一门“手艺活”,充满了刀耕火种式的原始操作。
刀耕火种的年代: 开发者通过
<script>标签手动管理 JavaScript 文件的依赖顺序。一个复杂的页面可能会有几十个<script>标签。这种“人肉运维”模式,极易因顺序错误导致“依赖地狱”,同时所有变量都暴露在全局作用域下,造成严重的变量污染。社区的早期探索: 为了解决这些问题,社区涌现出了一批先行者:
- 任务流工具 (Task Runner): 以
Grunt和Gulp为代表,它们可以自动化地执行一系列任务,如压缩代码、合并文件、编译 CSS。但它们关心的是“流程”,而非代码之间的“依赖关系”。 - 模块化加载器 (Module Loader): 以
RequireJS和Sea.js为代表,它们在浏览器端实现了模块化加载,解决了依赖管理和全局污染问题。但它们并未在“构建时”将模块打包,导致线上依然存在大量零散的 HTTP 请求。 - 破局者 Browserify: 它是现代打包工具思想的雏形。
Browserify创新地将 Node.js 的 CommonJS 模块规范引入了前端,让开发者能使用require来组织代码,并通过构建命令将所有依赖打包成一个文件。然而,它天生只为处理 JavaScript 而生,对于 CSS、图片等非 JS 资源的处理能力非常有限。
- 任务流工具 (Task Runner): 以
整个前端江湖,迫切地需要一个能统一管理所有类型资源、并深刻理解模块化依赖的终极解决方案。
8.2. Webpack 的“思想革命”:一切皆模块
Webpack 的登场,带来的不仅是一个工具,更是一种颠覆性的哲学——一切皆模块。
在 Webpack 的世界里,不再区分 JavaScript、CSS、图片、字体…… 开发者看到的 所有静态资源,都可以被视为“模块”,并能像 import 一个 JS 文件一样,被纳入到一个统一的 依赖图 中。
为了实现这一宏伟思想,Webpack 设计了两大核心基石:
Loader (加载器): 可以将其比喻为“翻译官”。Webpack 本身只理解 JavaScript 和 JSON 文件。当它在
import语句中遇到它不认识的“语言”(如.scss,.vue,.jsx文件,甚至是一张图片)时,Loader就负责登场,将其“翻译”成 Webpack 能理解的有效模块(通常是 JavaScript 字符串或文件路径)。Plugin (插件): 可以将其比喻为“架构师”。如果说 Loader 的工作是“点对点”的文件转换,那么 Plugin 则拥有更广阔的视野。它能“钩入(Hook)”到打包过程的各个生命周期节点,执行更复杂的任务,如打包优化、资源管理、环境变量注入等。我们所熟知的
HtmlWebpackPlugin(自动生成 HTML 文件并注入打包好的 JS)和DefinePlugin(定义全局常量)都是强大的插件。
“一切皆模块”的思想极大地解放了生产力。开发者终于可以像组织 JS 代码一样,去组织和管理整个项目的所有资源,实现了前端开发的真正“工程化”。
8.3. 登峰造极:Webpack 如何统治前端工程化
随着 React, Vue, Angular 等现代框架的兴起,复杂的单页应用(SPA)成为主流。这类应用对 代码分割、懒加载、Tree Shaking 等高级功能的需求激增,而 Webpack 在这些领域几乎没有对手,迅速成为各大框架脚手架(如 create-react-app, vue-cli)的内置核心,开启了它的统治时代。
Code Splitting (代码分割): 对于大型 SPA,将所有代码打包成一个文件是灾难性的。Webpack 允许我们通过动态导入语法
import(),将代码分割成多个“块”(chunks),只在需要时才去网络加载,极大地优化了应用的首屏性能。1
2
3
4
5
6// 点击按钮后,才去加载 login-modal.js 这个模块
loginButton.addEventListener('click', () => {
import('./components/login-modal.js').then(module => {
module.showLoginModal();
});
});Tree Shaking (摇树优化): 正如我们在上一章所学,Webpack 能通过静态分析 ES Module 的
import/export,在打包时移除所有未被引用的“死代码”,进一步减小打包体积。无与伦比的生态系统: Webpack 社区极其繁荣。无论是最新的 CSS 预处理器、前沿的 JS 语法,还是各类资源的优化,你几乎总能找到一个成熟的 Loader 或 Plugin 来解决问题。
8.4. “成也萧何,败也萧何”:Webpack 的“痛点”与性能瓶颈
Webpack 的强大,源于它“一切皆打包”的核心工作模式。然而,这也正是其“笨重”的根源。
8.4.1. “打包”带来的原罪:缓慢的开发服务器
Webpack Dev Server 的工作原理是:
- 启动时预打包: 在启动时,它必须先从入口文件出发,遍历整个项目的依赖,构建完整的依赖图,然后将它们全部打包成 bundle。
- 存入内存: 打包完成后,它并不会将文件写入磁盘,而是存放在内存中,以便快速提供给浏览器。
这个“先打包,再启动”的模式,导致项目越大、依赖越复杂,Starting the development server... 的等待时间就越长。一杯咖啡的时间,可能就耗在了等待项目启动上。
虽然 Webpack 的热模块替换(HMR)是革命性的,但它的更新速度依然受限于“重新打包”的速度。一个文件的改动,可能会触发一连串模块的重新构建,导致更新延迟。
8.4.2. 配置的“迷宫”:陡峭的学习曲线
Webpack 的极高灵活性和庞大生态,也带来了极其复杂的配置。这也是“前端配置工程师”这一戏称的由来。
前方高能:以下是一份中等复杂度的 webpack.config.js 真实片段。您无需理解其中任何一行代码,只需直观感受其复杂度和“代码感”。
1 | const path = require('path'); |
要正确写出这样的配置,开发者需要理解 entry, output, rules, loader, plugin, mode 等众多概念及其协同工作的方式,配置成本和心智负担非常高。
8.5. 时代的回响:Webpack 留下的宝贵遗产与未来的方向
Webpack 并非过去式: 必须强调,Webpack 5 在性能(如持久化缓存)和配置易用性上做出了巨大改进。在许多大型、成熟的生产环境中,它的稳定性和强大的生态依然是首选。
为后浪铺路: Webpack 沉淀下的核心思想,已被所有现代构建工具继承:
- 依赖图谱分析
- Loader/Plugin 架构思想
- 代码分割与 Tree Shaking 理念
- HMR 机制
新时代的破局点: 下一代工具的革命性突破,源于两大技术奇点的成熟:
- 浏览器原生支持 ES Module (ESM): 这是 Vite 等工具实现“闪电般”冷启动的 根本基石。开发时,构建工具可以跳过“打包”这一步,直接让浏览器按需去请求各个模块文件。
- 编译型语言的降维打击: 以 Go 语言编写的
esbuild和 Rust 语言编写的SWC,在编译、压缩等任务上,比基于 Node.js 的传统工具快上 数十甚至上百倍。
总结与过渡: Webpack 用它的“慢”和“繁”,深刻地教育了整个社区,让我们明白了前端工程化的极限在哪里。现在,Vite 正是站在 Webpack 这位巨人的肩膀上,利用 原生 ESM 和 高性能编译语言 这两大新式武器,去精准地解决那些曾经的“痛点”。至此,我们已经为学习 Vite 做好了最充分的知识和思想准备。
第九章:新时代的引擎轰鸣——Vite 全面精通
引言: 在第八章,我们站在历史的交汇点,理解了 Webpack 的伟大思想与时代局限。现在,让我们正式踏入由 Vite 开创的新纪元。Vite 并非简单地对 Webpack 进行修补,而是利用浏览器和编译工具链的代际优势,从根本上颠覆了“打包”这一核心环节。本章,我们将从其革命性的工作原理出发,深入配置实战,探索其强大的插件生态,并最终触及 SSR、库模式等高级应用场景,全面掌握这个现代前端开发的首选引擎。
9.1. 范式转移:从“先打包,再启动”到“即时服务”
9.1.1. 亲身体验:“魔法”是如何发生的
在深入理论之前,让我们先用一分钟时间,亲手见证 Vite 的“魔法”。
动手实践:请打开您的终端,执行以下命令来创建一个全新的 Vite 项目。
1 | # 我们使用 pnpm,速度更快 |
在交互式问答中,你可以为项目命名(如 vite-magic-show),并选择 Vanilla -> TypeScript 模板。这是一个不依赖任何框架的、纯净的 TypeScript 项目。
1 | # 进入项目目录 |
1
2
3
4
5
6
VITE v5.3.1 ready in 312 ms
➜ Local: http://localhost:5173/
➜ Network: use --host to expose
➜ press h + enter to show help
请注意这个时间:ready in 312 ms。Vite 几乎是瞬间就启动了服务。现在,用浏览器打开 http://localhost:5173/。
接下来,找到并打开 src/main.ts 文件,随意修改其中的内容,例如:
1 | // src/main.ts |
当您按下 Ctrl + S 保存的瞬间,浏览器中的页面几乎是 同步更新 的,没有任何可感知的延迟。
这就是 Vite 带来的第一个震撼:告别漫长的启动和更新等待,沉浸在 极致的心流开发体验 之中。
9.1.2. 根本原因剖析:两种模式的对决
这“魔法”的背后,是 Vite 和 Webpack 在底层工作模式上的 范式转移。
Webpack 的“预打包”模式:
回顾第八章,Webpack 在启动开发服务器时,必须从入口文件开始,遍历整个项目的依赖,构建一个完整的依赖图,然后将所有模块打包(Bundle)进内存。项目越大,这张图越复杂,启动前的“打包”耗时就越长,从而导致了漫长的“咖啡时间”。Vite 的“按需服务”模式:
Vite 则彻底颠覆了这个流程。它利用了现代浏览器原生支持的ES Module(ESM) 语法。- 启动时:Vite 仅启动一个轻量级的 Web 服务器,几乎是零开销。它 不需要进行任何打包操作。
- 浏览器请求:当浏览器加载
index.html并解析到<script type="module" src="/src/main.ts"></script>时,它会主动向 Vite 服务器发起一个对/src/main.ts的 HTTP 请求。 - Vite 响应:Vite 服务器接收到请求,对
/src/main.ts这个 单个文件 进行即时编译(例如将 TypeScript 转换为 JavaScript),然后直接返回给浏览器。 - 循环:如果
main.ts文件内部又有import了其他模块,浏览器会继续发起新的 HTTP 请求,Vite 也继续按需编译并返回。
在这个模式下,浏览器自身成为了“打包器”,它负责根据 import 语句来请求和组织模块。Vite 则退居为一个高效的、按需服务的“文件翻译官”。因此,项目的规模与启动时间彻底解耦,实现了恒定的、毫秒级的启动速度。
9.1.3. 热更新的“质变”
这种模式同样让 热模块替换 (HMR) 发生了质变。
- Webpack HMR: 当你修改一个模块时,Webpack 需要找出这个模块所属的 chunk(代码块),并重新计算和构建这整个 chunk,即使其中很多模块并未改变。
- Vite HMR: 当你修改一个模块(如
utils.ts)时,Vite 能利用 ESM 清晰的模块边界,精准地知道只有这一个模块失效了。它通过 WebSocket 通知浏览器:“嘿,utils.ts更新了,请重新请求它。” 浏览器接收到指令后,只会重新请求这一个文件,并凭借其原生的 ESM 处理能力,无缝地替换掉旧模块,而无需刷新整个页面或重新加载大量不相关的代码。
核心总结:Vite 的“快”,根植于它对 原生 ES Module 的极致利用。它将 Webpack 在启动时必须完成的繁重打包工作,巧妙地 分解、延迟 到了开发过程中的每一次浏览器实际请求中,从而实现了开发体验的代际飞跃。
9.2. Vite 的“双核引擎”:深入理解开发与生产模式的差异
Vite 的设计哲学中,最核心的一点就是 区分开发与生产。它认为,开发阶段我们最追求的是 极致的响应速度和调试体验,而生产阶段我们最追求的是 最优的加载性能和兼容性。为了同时达到这两个目标,Vite 创造性地采用了一套“双核引擎”架构。
9.2.1. 开发环境的“王牌”:原生 ESM + esbuild
我们在上一节体验的“即时服务”魔法,其背后的两大功臣,就是 浏览器原生 ESM 支持 和 esbuild。
在这个工作流中,esbuild 扮演着至关重要的角色。
esbuild是什么?
它是一个使用 Go 语言编写的、速度极快的 JavaScript Bundler / Transpiler / Minifier。由于 Go 语言是编译型语言,并且能充分利用多核 CPU 进行并行处理,esbuild在执行代码转换任务时,比用 JavaScript 编写的传统工具(如 Babel, Terser)快 10-100 倍。esbuild在 Vite 开发环境中的角色:在开发阶段,Vite 并不使用esbuild来“打包”,而是主要利用其 闪电般的“转译”能力。当浏览器请求一个main.ts文件时,Vite 会在瞬间调用esbuild将 TypeScript 代码转换为 JavaScript,然后返回给浏览器。对于.jsx或.tsx文件也是同理。
这可以看作是 Vite 对 Webpack ts-loader/babel-loader 链式调用的“降维打击”。Webpack 需要通过一系列基于 Node.js 的工具链来处理文件,而 Vite 直接调用了性能不在一个数量级的 esbuild,这是其能够实现“即时编译”的关键。
9.2.2. 生产环境的“守护神”:Rollup
一个核心疑问随之而来:既然开发时可以不打包,为什么执行 pnpm build 进行生产部署时,Vite 还是要打包呢?
这是因为直接将成百上千个未经优化的模块部署到线上,会带来严重的性能问题。Vite 在生产环境构建时,选择了一个久经考验、极其成熟的打包器——Rollup 来完成这项任务。
生产环境仍需打包的四大理由:
- 网络性能: 即使有 HTTP/2,同时发起成百上千个模块的 HTTP 请求也会在浏览器和服务器端造成巨大的网络开销和拥堵,形成“请求瀑布流”,严重拖慢页面加载速度。打包能将这些请求合并为少数几个。
- 更优的 Tree Shaking: Rollup 是最早普及 Tree Shaking 概念的打包器之一,它基于 ESM 的静态分析能实现非常彻底的死代码消除,确保最终产物中不包含任何一行无用代码,这是单纯的浏览器 ESM 加载无法做到的。
- 代码分割: Rollup 能进行智能的代码分割,将应用代码拆分成多个按需加载的块(chunks),进一步优化首屏加载性能。
- 统一优化与兼容: 打包过程可以统一进行代码压缩、混淆、以及通过插件(如 Babel)处理对旧版浏览器的兼容性问题,确保最终代码在各种环境下的健壮性。
为什么选择 Rollup?
Rollup 由 Vue 的作者尤雨溪(也是 Vite 的作者)长期使用和贡献,它打包输出的 ES Module 格式代码非常“干净”,副作用少,是开发 JS 库的首选。Vite 沿用其成熟的打包能力和庞大的插件生态,来为生产环境的最终产物保驾护航,是一个非常明智的选择。
核心总结: Vite 的“双核”策略,是在开发者体验和用户体验之间做出的完美权衡。
- 开发时 (
esbuild): 牺牲一些最终产物的优化,换取极致的编译速度和即时反馈。 - 生产时 (
Rollup): 花费必要的打包时间,换取用户浏览器中最佳的加载性能和运行表现。
9.3. “秘密武器”:依赖预构建全解析
我们在 9.1 节中建立的核心认知是:Vite 开发服务器通过按需服务源码文件来避免“打包”。然而,这个原则有一个重要的例外:它 不适用 于 node_modules 里的 第三方依赖。
Vite 会在首次启动时,花费少量时间对第三方依赖进行“预构建”,这是一个极其聪明的优化策略,旨在解决两大痛点。
9.3.1. 它要解决的两大痛点
1. 模块格式兼容:将 CommonJS (CJS) 统一为 ES Module (ESM)
尽管我们正在全面拥抱 ES Module,但 node_modules 中依然有大量以 CommonJS 格式发布的历史悠久的优秀库(例如 react 的部分依赖)。浏览器本身 完全不认识 CommonJS 的 require() 和 module.exports 语法。如果不进行处理,浏览器在请求这些模块时会直接报错。
解决方案: Vite 使用 esbuild 扫描 node_modules,找到所有 CommonJS 格式的依赖,并将它们强制转换为浏览器友好的 ES Module 格式。
2. 性能瓶颈:避免“请求瀑布流”
一些现代库虽然以 ESM 格式发布,但其内部可能由成百上千个细碎的模块文件组成(一个典型的例子是 lodash-es)。
场景: 假设你在代码中 import { debounce } from 'lodash-es'。debounce 函数本身可能又 import 了其他十几个内部工具函数。如果 Vite 对这些内部 import 也进行“按需服务”,浏览器为了加载一个小小的 debounce 功能,就可能需要同时发起数十个甚至上百个 HTTP 请求。这种“请求瀑布流”会严重阻塞浏览器渲染,让开发体验变得卡顿。
解决方案: 预构建再次使用 esbuild,将这些由许多小文件组成的 ESM 依赖 打包 成一个或少数几个大的 ESM 文件。这样,当浏览器请求 lodash-es 时,只需要一次 HTTP 请求就能获取全部所需代码。
9.3.2. 工作原理与缓存揭秘
依赖预构建的流程如下:
- 扫描: Vite 启动后,会首先扫描你源码中所有的
import和require语句,找出所有指向node_modules的“裸模块导入”。 - 打包: 它将找到的所有第三方依赖作为入口,调用
esbuild将它们打包成符合浏览器标准的 ESM 文件。 - 缓存: 打包产物被存放在项目根目录的
node_modules/.vite/deps目录下。每个预构建的依赖都会生成一个 JS 文件,以及一个记录元信息的_metadata.json文件。 - 重写: Vite 会重写你的
import路径。例如,你代码中的import React from 'react'会被重写为import React from '/node_modules/.vite/deps/react.js?v=xxxx',从而精确地指向缓存文件。
后续,只要依赖关系没有变化,Vite 每次启动都会直接使用这份缓存,这也是即使是大型项目,Vite 第二次及以后的启动也能“秒开”的核心原因。
9.3.3. 触发时机与强制重建
预构建 不会 在每次启动时都运行。它只在以下情况被触发:
- 首次启动开发服务器时。
- 当
package.json、lock文件或vite.config.ts中的依赖相关配置发生变化后。
在某些特殊情况下,例如你手动修改了 node_modules 里的某个文件进行调试,或者缓存出现了问题,你可能需要 手动强制重建 依赖缓存。这可以通过在启动命令后添加 --force 标志来实现。
1 | # 强制 Vite 重新进行依赖预构建 |
1
2
3
4
5
6
Forced re-optimization of dependencies
VITE v5.3.1 ready in 2854 ms
➜ Local: http://localhost:5173/
...
你会发现,添加 --force 后,启动时间会回到首次启动时的秒级水平,因为 Vite 重新执行了完整的预构建流程。
核心总结:依赖预构建是 Vite 为解决 node_modules “历史遗留问题”和“性能短板”而祭出的“秘密武器”。它通过一次性的预处理,将混乱、低效的第三方依赖,转化为浏览器能最高效识别的 ESM 格式,从而在不牺牲“按需服务”源码优势的前提下,保证了开发服务器的整体高性能。
9.4. 指挥中心:vite.config.ts 实战精解
Vite 奉行“约定优于配置”的原则,在零配置下就已经非常强大。但对于一个严肃的项目,自定义配置是必不可少的。我们可以在项目根目录下创建一个 vite.config.ts 文件来对 Vite 进行配置。
为什么是 .ts? Vite 天然支持 TypeScript 配置文件。强烈推荐使用 .ts 后缀,这样你可以享受到 IDE 提供的类型提示和自动补全,让配置过程更安全、更便捷。
基础配置结构:
文件路径: vite-magic-show/vite.config.ts
1 | import { defineConfig } from 'vite'; |
9.4.1. 核心配置与环境变量
root: 指定项目根目录(index.html所在的位置),默认为process.cwd()。base: 开发或生产环境下的公共基础路径。例如,如果你的应用部署在https://prorise.com/app/下,那么base应设置为'/app/'。mode: 模式,默认为'development'(dev命令)或'production'(build命令)。define: 定义全局常量替换。在开发时是全局变量,构建时是静态替换。例如define: { __APP_VERSION__: JSON.stringify('1.0.0') }。envDir: 用于加载.env文件的目录,默认为根目录。
实战:配置部署路径和注入构建信息
问题场景: 我们的项目需要部署到服务器的 /my-app/ 子目录下。同时,我们希望在应用中可以展示当前的版本号和构建时间。
解决方案: 使用 base 和 define 选项。
文件路径: vite.config.ts
1 | import { defineConfig } from 'vite'; |
在代码中使用:
文件路径: src/main.ts
1 | console.log(`App Version: ${__APP_VERSION__}`); |
实战:管理环境变量
在真实项目中,API 地址、密钥等信息在开发和生产环境通常是不同的。Vite 通过 .env 文件对此提供了顶级支持。
在项目根目录创建两个文件:
文件路径:.env.development1
2# 开发环境 API 地址
VITE_API_URL=http://localhost:8080/api/v1文件路径:
.env.production1
2# 生产环境 API 地址
VITE_API_URL=https://api.prorise.com/api/v1重要约定:为了安全,Vite 只会暴露以
VITE_为前缀的变量给客户端代码。在你的源码中访问这些变量:
文件路径:src/api.ts1
2
3
4
5const API_URL = import.meta.env.VITE_API_URL;
export function fetchUserData() {
return fetch(`${API_URL}/users`);
}当你运行
pnpm dev时,API_URL的值是http://localhost:8080/api/v1;当你运行pnpm build时,打包出的代码中API_URL的值会自动变为https://api.prorise.com/api/v1。
9.4.2. 开发服务器 (server)
这是用于配置 Vite Dev Server 的选项。
host: 指定服务器主机名,默认为'localhost'。port: 指定服务器端口,默认为5173。open: 在服务器启动时自动在浏览器中打开应用。proxy: (极其常用) 配置自定义请求代理,解决开发时的跨域问题。
实战:配置 API 代理解决跨域
问题场景: 你的前端应用运行在 http://localhost:5173,但需要调用的后端 API 运行在 http://localhost:8080。由于浏览器的同源策略,直接请求会触发 CORS 跨域错误。
解决方案: 在 vite.config.ts 中配置 proxy,让 Vite Dev Server 帮你转发请求。
1 | import { defineConfig } from 'vite'; |
配置完成后,你在代码中发起的 fetch('/api/users') 请求,实际上会被 Vite 服务器转发到 http://localhost:8080/users,从而完美绕开了浏览器的跨域限制。
9.4.3. 构建配置 (build)
这些选项用于控制生产环境的构建过程 (pnpm build)。
outDir: 指定输出路径,默认为dist。assetsDir: 指定生成静态资源的存放路径,默认为assets。sourcemap: 是否生成 source map 文件。true或'inline'。开启后便于线上代码调试。minify: 指定使用哪种混淆器,默认为'esbuild'(速度极快)。设为false可禁用混淆。rollupOptions: 传递给 Rollup 的高级选项,用于更精细的构建控制。
实战:优化生产环境的打包输出
问题场景: 我们希望将最终打包的文件输出到 prod-dist 目录,并为了方便管理,将 JS、CSS 和图片等资源分别存放到不同的子文件夹中。同时,为了线上调试,我们希望生成独立的 source map 文件。
解决方案: 配置 build 选项,特别是 rollupOptions。
文件路径: vite.config.ts
1 | import { defineConfig } from 'vite'; |
执行 pnpm build 后,你的 prod-dist 目录结构会像这样:
1 | prod-dist/ |
9.4.4. 解析 (resolve)
用于配置模块的解析行为。
alias: (极其常用) 配置路径别名。
实战:配置 @ 路径别名
问题场景: 在深层嵌套的组件中,你可能需要写这样的导入语句:import { Button } from '../../../components/Button',这种相对路径既不美观也难以维护。
解决方案: 配置 alias,让 @ 符号直接指向 src 目录。
准备工作: 为了在 vite.config.ts 中正确使用 Node.js 的内置模块(如 path)并获得类型提示,你需要安装它的类型定义文件。这是一个开发依赖,因为它只在开发阶段需要。
请在你的项目终端中运行以下命令:
1 | # 使用 pnpm |
安装完成后,现在可以修改配置文件了。
文件路径: vite.config.ts
1 | import { defineConfig } from 'vite'; |
配置完成后,你就可以在任何地方使用清爽的绝对路径导入了:
1 | // 之前: import { Button } from '../../../components/Button'; |
这极大地提升了代码的可读性和项目维护性。
核心总结: vite.config.ts 是你驾驭 Vite 的“方向盘”和“仪表盘”。虽然 Vite 开箱即用,但熟练掌握 server.proxy 和 resolve.alias 这两大配置,并善用 .env 文件管理环境变量,是区分“入门”与“熟练”的关键分水岭,也是构建任何真实项目的基础。
9.5. 一等公民:Vite 中的 CSS 工程化方案
在前端工程化中,对 CSS 的管理始终是一个复杂但至关重要的环节。Webpack 通过一套复杂的 Loader 链条(style-loader, css-loader, postcss-loader, sass-loader 等)来处理样式,而 Vite 则将 CSS 视为项目中的“一等公民”,提供了开箱即用的、功能强大的工程化方案。
9.5.1. 开箱即用的体验
让我们回想一下在 Webpack 中处理 SCSS 文件需要做的配置:
1 | // webpack.config.js (示例) |
你需要安装三个独立的 loader,并正确配置它们的顺序。
而在 Vite 中,你所需要做的仅仅是:
- 安装相应的预处理器:
1
pnpm add -D sass
- 在你的组件中直接引入
.scss文件:
文件路径:src/main.ts1
import './styles/main.scss';
然后,它就直接工作了。 Vite 会自动检测文件扩展名,并调用已安装的相应预处理器进行处理,无需任何额外配置。这种零配置的体验,极大地降低了项目初始化的复杂度。
9.5.2. 实战技巧
Vite 不仅提供了基础支持,还内置了多种能显著提升开发效率的实战技巧。
1. @import 路径别名解析
在 9.4.4 节中,我们已经配置了 @ 指向 src 目录的路径别名。这个别名同样可以在 CSS 文件中无缝使用。
文件路径: src/components/Header.scss
1 | // 无需再使用 ../../ 这样的相对路径 |
这使得样式文件的维护性和可移植性大大增强。
2. 将 CSS 作为字符串导入 (?inline)
在某些特殊场景下,你可能需要获取 CSS 的内容作为字符串,而不是直接将其注入到页面中(例如,在 Web Components 的 Shadow DOM 中动态创建 <style> 标签)。Vite 通过 ?inline 后缀提供了这个能力。
文件路径: src/components/MyComponent.ts
1 | import cssString from './MyComponent.scss?inline'; |
3. CSS Modules:实现组件级样式隔离
问题场景: 在大型项目中,不同组件的 CSS 类名很容易发生冲突。你在 Header.css 中定义的 .title 样式,可能会意外地污染到 Footer.css 中的 .title 样式。
解决方案: 使用 CSS Modules。Vite 对此提供了顶级的支持。只需将你的样式文件命名为 *.module.css (或 .module.scss 等)。
文件路径: src/components/Button.module.scss
1 | // 定义一个局部作用域的类 |
在组件中这样使用它:
文件路径: src/components/Button.ts
1 | import styles from './Button.module.scss'; |
Vite 会将 .button 这个类名编译成一个唯一的、带有哈希值的字符串(如 Button_button_a1B2c),从而保证这个样式 只对当前组件生效,彻底杜绝了全局样式污染的问题。
4. 全局注入 SCSS/Less 变量
问题场景: 你的项目中有一个 _variables.scss 文件,定义了所有的主题颜色、字体大小等。你希望在 所有 的 .scss 文件中都能直接使用这些变量,而不想在每个文件的开头都手动写一遍 @import '@/styles/_variables.scss';。
解决方案: 使用 css.preprocessorOptions 配置。
文件路径: vite.config.ts
1 | import { defineConfig } from 'vite'; |
完成这个配置后,Vite 在编译任何 .scss 文件之前,都会自动在文件内容的 最前面 注入 @import "@/styles/_variables.scss"; 这行代码。现在,你可以在项目的任何一个 .scss 文件中直接使用 $primary-color 等全局变量了,极大地提升了主题管理的便利性。
9.5.3. PostCSS:CSS 的“Babel”
在我们深入 Vite 更多高级 CSS 功能之前,必须先认识一个在幕后默默工作的“大功臣”——PostCSS。当你看到像 Tailwind CSS 或 DaisyUI 这样神奇的 CSS 框架时,驱动它们的核心技术之一就是 PostCSS。
为了理解 PostCSS,最好的方式是将它与我们已经熟悉的 Babel 进行类比:
- Babel:接收我们写的 JavaScript 代码,将其解析成一种通用的数据结构(AST),然后通过各种插件(如
preset-env)对这个结构进行修改(比如将箭头函数转为普通函数),最后再把这个结构转换回浏览器兼容的 JavaScript 代码。 - PostCSS:做着完全一样的事情,但 处理的对象是 CSS。它接收我们写的 CSS 代码,将其解析成 AST(抽象语法树),然后通过各种插件(如
autoprefixer)对这个结构进行修改(比如添加浏览器厂商前缀),最后再转换回标准的 CSS 代码。
核心认知:PostCSS 本身 几乎不做任何事。它不是一个像 Sass 或 Less 那样的 CSS 预处理器,它不会给你提供变量、嵌套等新语法。PostCSS 是一个平台,一个让你可以用 JavaScript 插件来转换和增强 CSS 的平台。
PostCSS 的威力体现在其强大的插件生态上,最著名的两个例子是:
autoprefixer: 这是最经典的 PostCSS 插件。它会自动读取 Can I Use 网站的数据,为你的 CSS 规则(如display: grid)自动添加所需的浏览器厂商前缀(如-ms-grid),让你从兼容性的琐事中解放出来。tailwindcss: Tailwind CSS 框架本身就是一个 PostCSS 插件。它会在构建时,扫描你的html和.js/.ts文件,找到所有原子化类名(如text-center,p-4),然后动态地生成你所需要的全部 CSS。
在 Vite 中使用 PostCSS
Vite 对 PostCSS 提供了开箱即用的支持。你无需进行任何配置,Vite 就会自动处理项目中的 PostCSS 配置。
实战:为项目添加 autoprefixer
第一步:安装依赖
1 | pnpm add -D postcss autoprefixer |
第二步:创建 PostCSS 配置文件
在项目根目录创建 postcss.config.js 文件。Vite 会自动识别并加载它。
文件路径: postcss.config.js
1 | module.exports = { |
完成了! 就是这么简单。现在,当 Vite 处理你的 CSS 文件时,会自动通过 PostCSS 和 autoprefixer,为你的样式添加必要的浏览器前缀,确保最佳的兼容性。
9.6. Vite 插件开发与应用
引言: 如果说 vite.config.ts 是 Vite 的“指挥中心”,那么插件系统就是它的“灵魂”与无限潜能的源泉。它允许我们深入构建流程的每一个环节,实现代码转换、服务扩展、产物优化等任何可以想象到的功能。本节将系统地讲解 Vite 插件的机制、应用与开发,内容覆盖从使用社区优秀插件到从零编写企业级自定义插件的全过程。
9.6.1. 核心机制:在实战中理解插件如何工作
理论是枯燥的,让我们从一个最简单的“痛点”出发,用实战来开启 Vite 插件的大门。
痛点场景:在开发过程中,我们想知道 Vite 究竟处理了我们项目中的哪些文件,希望能 在每次文件被转换时,在终端打印出它的路径。
这是一个 Vite 自身配置项无法满足的需求,却是插件的完美用武之地。
第一步:创建你的第一个插件
- 在项目根目录创建一个
plugins文件夹,用于存放我们自定义的插件。 - 在
plugins文件夹中,创建一个vite-plugin-inspect.ts文件。
现在,写入我们插件的核心代码:
文件路径: plugins/vite-plugin-inspect.ts
1 | import type { Plugin } from 'vite'; |
第二步:在 vite.config.ts 中使用它
1 | import { defineConfig } from 'vite'; |
第三步:见证实战效果
现在,启动你的开发服务器:
1 | pnpm dev |
当你刷新浏览器页面时,观察你的终端,会看到 Vite 打印出了它处理的每一个文件!
1 | Vite 正在处理: D:/web/vite-magic-show/src/main.ts |
通过这个简单的实践,我们已经可以开始剖析插件的核心机制了。
插件的本质
正如你所见,一个 Vite 插件就是一个返回特定对象的 JavaScript 函数。这个对象必须有一个 name 属性用于识别,其核心则是一系列被称为 钩子 (Hooks) 的函数(如我们刚才用的 transform)。Vite 在构建流程的特定阶段会自动调用这些钩子。
API 架构:兼容 Rollup 并扩展
我们刚才使用的 transform 钩子,实际上是继承自 Rollup 的。Vite 的插件 API 是 Rollup 插件接口的一个 超集。这意味着,绝大多数 Rollup 插件都能直接在 Vite 中使用,让 Vite 共享了一个庞大而成熟的生态。
同时,Vite 增加了许多 独有的钩子 来控制开发服务器。让我们来为刚才的插件增加一个 Vite 独有钩子 configureServer,它只在 pnpm dev 启动时运行一次。
文件路径: plugins/vite-plugin-inspect.ts (升级版)
1 | import type { Plugin, ViteDevServer } from 'vite'; |
现在再次运行 pnpm dev,你会在启动信息后看到我们自定义的欢迎语。这个 configureServer 钩子就是 Vite 强大开发体验的扩展点之一。
执行顺序与 enforce 属性
当使用多个插件时,它们的执行顺序由 enforce 属性决定,分为三个阶段:
pre: 在 Vite 核心插件 之前 执行。default: 在 Vite 核心插件 之后 执行。(默认值)post: 在 Vite 构建插件 之后 执行。
例如,如果你希望你的日志插件总是在所有其他插件转换代码 之前 运行,你可以这样配置:
1 | // vite.config.ts |
9.6.2. 核心钩子“配方”:深入 Vite 构建的生命周期
在正式开始前,我们先为插件开发 准备好类型环境,这是所有后续实战的基础。
核心上下文:Vite 的配置文件及所有插件都运行在 Node.js 环境 中。因此我们可以使用 fs, path 等内置模块。为了让 TypeScript “认识”它们,我们需要安装其类型定义包。
环境准备:安装 Node.js 类型定义
1 | pnpm add -D @types/node |
安装后,TypeScript 就不会再对 Node.js 的相关 API 报错了。
本节,我们将通过下表中一系列源于真实开发痛点的“插件配方”,来学习最有代表性的钩子函数。
| 痛点场景 | 解决方案 | 核心钩子 |
|---|---|---|
| 在代码中需要动态的 构建时信息(版本号、Git 提交哈希等)。 | 编写一个插件,通过 define 选项将信息 注入为全局常量。 | config |
| 前后端分离开发,后端接口未就绪,前端开发被阻塞。 | 编写一个插件,在 Dev Server 中 创建动态 Mock API。 | configureServer |
希望直接 import 文件系统中不存在 的、由程序动态生成的模块。 | 编写一个插件,凭空 创造一个“虚拟模块”。 | resolveId, load |
希望 import 一种 自定义文件类型(如 .txt),并自动将其转换为所需格式。 | 编写一个插件,转换特定文件内容,例如将纯文本转为 HTML 字符串。 | transform |
| 构建完成后,需要执行一些 自动化收尾工作,如压缩产物、上传 CDN。 | 编写一个插件,在构建结束后 执行自定义脚本。 | closeBundle |
配方一:注入动态构建信息 (config)
Vite 启动时:当 Vite 读取 vite.config.js 文件并初始化配置时,会调用插件的 config 钩子。
痛点: 我们希望在应用中展示版本号、构建时间或最新的 Git 提交信息,以便于测试和追溯问题,但这些信息是动态的,手动维护非常麻烦。
解决方案: 利用 config 钩子,统一收集所有需要的构建时信息,并通过 Vite 的 define 选项,安全、干净地注入到一个全局常量中。
插件实现: plugins/vite-plugin-app-info.ts
1 | import type { Plugin } from 'vite'; |
效果验证:
- 在
src/vite-env.d.ts中声明全局类型。 - 在
src/main.ts中使用__APP_INFO__变量并将其显示在页面上。每次构建,这些信息都会自动更新。
配方二:创建动态 Mock 服务 (configureServer)
Vite 启动开发服务器时(即运行 vite 或 vite dev 命令时)
痛点: 后端接口未就绪或不稳定,导致前端开发被阻塞。
解决方案: 利用 configureServer 钩子向 Vite 开发服务器中注入一个自定义中间件,该中间件 动态加载 mock/ 目录下的所有模块化配置文件,并结合 mockjs 生成动态数据,完美实现 热更新。
插件实现: plugins/vite-plugin-api-mock.ts
1 | import type { Plugin } from 'vite'; |
效果验证:
- 安装
mockjs和glob。
1 | pnpm add -D mockjs glob |
- 创建
mock/user.ts文件并定义 mock 数据结构。
1 | // 我们导出一个符合特定结构的对象 |
- 在
src/main.ts中fetch('/api/user-info')。运行pnpm dev,你会看到请求返回了随机生成的数据,并且修改 mock 文件无需重启服务即可生效。
1 | fetch('/api/user-info') |
配方三:创建虚拟模块 (resolveId & load)
引言: 在日常开发中,你可能已经见过一些神奇的 import,例如 import routes from 'virtual:routes'。这些在文件系统中找不到的模块,就是“虚拟模块”。虽然从零编写虚拟模块插件不是日常任务,但理解其原理,能帮助你揭开许多现代框架和库(如文件式路由、图标库)背后‘魔法’的秘密。这是一个 进阶概念,但能极大地拓宽你的技术视野。
当 Vite 遇到一个导入语句时,会调用 resolveId 钩子来确定模块的实际路径。
在 resolveId 成功解析模块路径之后,Vite 会调用 load 来获取模块源码。
痛点: 我正在开发一个博客或文档网站。我需要在首页展示所有文章的列表(包含标题、日期等元信息)。目前,我每写一篇新的 Markdown 文章,都必须 手动 去一个集中的列表文件(如
posts.ts)中添加一条新的记录。这个过程非常繁琐、容易遗漏,且违反了“单一信源”原则。解决方案: 创建一个名为
virtual:posts-index的 虚拟模块。当我们的代码import这个模块时,插件会 在构建时自动扫描src/posts目录下的所有 Markdown 文件,解析每个文件头部的frontmatter元信息,并动态生成一个包含所有文章信息的数组导出。从此,文章列表的维护将完全自动化
第一步:准备工作
安装依赖: 我们需要一个库来解析 Markdown 文件中的
frontmatter。gray-matter是一个优秀的选择。1
pnpm add -D gray-matter
创建内容文件: 在
src目录下创建一个posts文件夹,并放入两篇示例文章。文件路径:
src/posts/first-post.md1
2
3
4
5
6---
title: 我的第一篇文章
date: '2025-08-31'
author: Prorise
---
这是文章的正文内容...文件路径:
src/posts/second-post.md1
2
3
4
5
6---
title: Vite 插件太酷了
date: '2025-09-01'
author: Prorise
---
插件让一切皆有可能。
第二步:插件实现
文件路径: plugins/vite-plugin-posts-index.ts
1 | import type { Plugin } from 'vite'; |
第三步:效果验证
配置插件: 在
vite.config.ts中引入并使用postsIndexPlugin。声明虚拟模块类型: 在
src/vite-env.d.ts中添加类型声明,享受 TypeScript 的智能提示。
文件路径:src/vite-env.d.ts1
2
3
4
5
6
7
8
9
10
11/// <reference types="vite/client" />
declare module 'virtual:posts-index' {
const posts: {
title: string;
date: string;
author: string;
slug: string;
}[];
export default posts;
}在应用中使用: 在
src/main.ts中导入并渲染这个自动生成的文章列表。
文件路径:src/main.ts1
2
3
4
5
6
7
8
9
10
11
12import allPosts from 'virtual:posts-index';
const app = document.querySelector<HTMLDivElement>('#app')!;
const postsHtml = allPosts.map(post => `
<div style="border: 1px solid #ccc; padding: 10px; margin-bottom: 10px;">
<h2>${post.title}</h2>
<p>作者: ${post.author} | 发布于: ${post.date}</p>
</div>
`).join('');
app.innerHTML += `<h1>文章列表</h1>${postsHtml}`;运行
pnpm dev,刷新页面,你将看到一个根据src/posts目录内容自动生成的、按日期排序的文章列表。现在,你可以尝试在src/posts目录中新增或删除.md文件,然后刷新浏览器,列表会立即自动更新!这完美地解决了我们最初的痛点。
配方四:自定义文件转换 (transform)
- 痛点: 我希望能在项目中直接
import一个.txt文件,并让它的内容自动转换成一段安全的 HTML 字符串(例如,每行都包在<p>标签里)。 - 解决方案: 利用
transform钩子,编写一个插件来拦截所有对.txt文件的导入请求,并将其内容转换为我们想要的 HTML 字符串格式。
插件实现: plugins/vite-plugin-txt-to-html.ts
1 | import type { Plugin } from 'vite'; |
效果验证:
创建
.txt文件:
在src目录下创建一个notes文件夹,并放入my-note.txt文件。
文件路径:src/notes/my-note.txt1
2这是第一行笔记。
这是第二行笔记,包含一些 <html> 特殊字符。在应用中使用:
在src/main.ts中导入并使用它。
文件路径:src/main.ts1
2
3
4import noteHtml from './notes/my-note.txt';
const app = document.querySelector<HTMLDivElement>('#app')!;
app.innerHTML += `<h2>My Note:</h2> ${noteHtml}`;运行
pnpm dev,刷新页面,你将看到.txt文件的内容被安全地渲染成了 HTML 段落。
配方五:构建后自动化任务 (closeBundle)
- 痛点: 每次构建完成后,我都需要手动把
dist目录压缩成一个deploy.zip包。这个重复性工作完全可以自动化。 - 解决方案: 利用
closeBundle钩子,在 Vite 构建流程 完全结束之后 执行自定义的 Node.js 脚本来压缩产物。
插件实现: plugins/vite-plugin-compress-dist.ts
1 | import type { Plugin, ResolvedConfig } from 'vite'; |
效果验证:
安装依赖:
1
pnpm add -D archiver
配置插件:
将compressDistPlugin添加到vite.config.ts的plugins数组中。执行构建:
1
pnpm build
1
2
3
4
5
6
7
8
9vite v5.3.1 building for production...
✓ 30 modules transformed.
prod-dist/index.html 0.48 kB │ gzip: 0.32 kB
prod-dist/static/css/index-....css 0.03 kB │ gzip: 0.05 kB
prod-dist/static/js/index-....js 52.54 kB │ gzip: 21.04 kB
✅ ZIP created: D:\path\to\project\dist.zip (0.05 MB)
✨ Build completed in 2.31s.构建流程的最后,你会在终端看到
✅ ZIP created...的提示,并且项目根目录下会自动生成一个dist.zip压缩文件。
9.6.3. 社区优秀插件集成与实战
Vite 的真正威力,有很大一部分来自于其活跃、创新的插件生态。学会发现、评估和集成社区插件,是衡量一个工程师能力的重要标准。本节,我们将以“卡片”的形式,为您逐一介绍一些最流行、最能提升开发体验的优秀插件。
1. unplugin-auto-import 自动按需导入
一句话解决什么问题:自动按需导入 API,让你告别冗长的 import { ref, computed } from 'vue' 或 import { useState, useEffect } from 'react'。
痛点: 在日常开发中,我们需要反复从框架或库中导入相同的 API,这些重复的 import 语句不仅占用了代码空间,也增加了心智负担。
解决方案: unplugin-auto-import 会扫描你的代码,自动识别使用到的 API,并在需要时“隐式地”为你注入导入语句。
实战配置与效果
- 安装依赖:
1
pnpm add -D unplugin-auto-import
- 配置
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11
12import AutoImport from 'unplugin-auto-import/vite';
export default defineConfig({
plugins: [
AutoImport({
// 定义需要自动导入的库
imports: ['vue', 'react', 'vue-router'],
// 指定生成 d.ts 文件的位置,用于 TypeScript 类型提示
dts: 'src/auto-imports.d.ts',
}),
],
}); - 效果展示 (以 Vue 为例):
使用前:使用后:1
2
3
4
5<script setup>
import { ref, computed } from 'vue';
const count = ref(0);
const double = computed(() => count.value * 2);
</script>1
2
3
4
5<script setup>
// ref 和 computed 都是自动导入的,可以直接使用,代码更纯粹
const count = ref(0);
const double = computed(() => count.value * 2);
</script>
2. vite-plugin-svg-icons 自动化雪碧图
一句话解决什么问题:自动化 SVG 雪碧图方案,将多个 SVG 图标打包成一个大的符号集合,通过 <use> 标签按需引用,提升性能与管理效率。
痛点: 管理几十上百个零散的 SVG 图标文件非常繁琐,且每个图标作为独立文件请求也会影响性能。
解决方案: 该插件会创建一个 virtual:svg-icons-register 虚拟模块,将指定目录下的所有 SVG 图标打包成一个 SVG 雪碧图注入到 body 中。
实战配置与效果
- 安装依赖:
pnpm add -D vite-plugin-svg-icons - 配置
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11import { createSvgIconsPlugin } from 'vite-plugin-svg-icons';
import path from 'path';
export default defineConfig({
plugins: [
createSvgIconsPlugin({
iconDirs: [path.resolve(process.cwd(), 'src/assets/icons')],
symbolId: 'icon-[dir]-[name]',
}),
],
}); - 在
src/main.ts中引入注册脚本:1
import 'virtual:svg-icons-register';
- 效果展示: 假设你在
src/assets/icons目录下有一个user.svg,现在可以在任何地方通过<svg>标签方便地使用它。1
2
3<svg aria-hidden="true" width="20" height="20">
<use href="#icon-user" fill="currentColor" />
</svg>
3. rollup-plugin-visualizer 可视化分析
一句话解决什么问题:可视化分析打包产物,让你清楚地知道是什么占用了你的包体积,是性能优化的“侦察兵”。
痛点: 项目构建后的 bundle 文件体积过大,但不知道具体是哪个依赖或模块导致的。
解决方案: visualizer 插件会在构建结束后,生成一个交互式的 HTML 文件,用矩形树图清晰地展示产物中所有模块的体积占比。
实战配置与效果
- 安装依赖:
pnpm add -D rollup-plugin-visualizer - 配置
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11import { visualizer } from 'rollup-plugin-visualizer';
export default defineConfig({
plugins: [
visualizer({
open: true, // 在默认浏览器中自动打开报告
gzipSize: true,
brotliSize: true,
}),
],
}); - 效果展示:
执行pnpm build后,Vite 会自动在浏览器中打开一个名为stats.html的分析报告。通过这个图表,你可以轻松定位到需要进行代码分割或替换的“大体积”模块。
4. vite-plugin-pages 自动生成路由
一句话解决什么问题:基于文件目录结构,自动生成 vue-router 的路由配置,实现“文件即路由”。
痛点: 在 Vue Router 中,每新增一个页面,都需要手动在 router/index.ts 中 import 组件并添加一条新的路由配置,非常繁琐且容易出错。
解决方案: 该插件会扫描 src/pages 目录的结构,自动生成对应的路由配置数组,并通过虚拟模块提供给应用使用。
实战配置与效果
- 安装依赖:
pnpm add -D vite-plugin-pages - 文件目录结构约定:
1
2
3
4
5
6src/pages/
├── index.vue
├── about.vue
└── user/
├── index.vue
└── [id].vue - 效果展示:
该插件会自动生成等价于下面这样的路由配置,我们无需手写任何路由代码:这个插件完美地诠释了“约定优于配置”,将繁琐的路由配置工作完全自动化。1
2
3
4
5
6
7// 这是插件在内存中生成的路由配置(概念)
[
{ path: '/', component: '/src/pages/index.vue' },
{ path: '/about', component: '/src/pages/about.vue' },
{ path: '/user', component: '/src/pages/user/index.vue' },
{ path: '/user/:id', component: '/src/pages/user/[id].vue' }, // 动态路由
]
5. unplugin-vue-components 按需导入-vue 加强版
一句话解决什么问题:自动按需导入并注册 Vue 组件,让你在 <template> 中直接使用组件,无需 import 和 components 选项。
痛点: 与 unplugin-auto-import 类似,每个组件都需要手动 import 并(在选项式 API 中)注册。当页面中组件繁多时,<script> 部分会变得非常臃肿,且都是模板化的引入代码。
解决方案: 该插件会扫描你的模板文件,自动发现使用的组件标签,并按需从指定目录或 UI 库中导入对应的组件。它是 unplugin-auto-import 的完美搭档。
实战配置与效果
- 安装依赖:
1
pnpm add -D unplugin-vue-components
- 配置
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import Components from 'unplugin-vue-components/vite';
// 如果你使用像 Element Plus 这样的 UI 库,可以引入它的解析器
import { ElementPlusResolver } from 'unplugin-vue-components/resolvers';
export default defineConfig({
plugins: [
Components({
// 指定组件位置,默认是 'src/components'
dirs: ['src/components'],
// 指定生成 d.ts 文件的位置
dts: 'src/components.d.ts',
// 配置需要自动导入的 UI 库解析器
resolvers: [ElementPlusResolver()],
}),
],
}); - 效果展示:
使用前:使用后:1
2
3
4
5
6
7
8<template>
<MyHeader />
<el-button>Click Me</el-button>
</template>
<script setup>
import MyHeader from './components/MyHeader.vue';
import { ElButton } from 'element-plus';
</script>1
2
3
4
5
6
7
8<template>
<!-- MyHeader 和 ElButton 都可以直接使用,无需任何 import -->
<MyHeader />
<el-button>Click Me</el-button>
</template>
<script setup>
// <script> 区域变得无比干净!
</script>
6. vite-plugin-compression 自动压缩
一句话解决什么问题:在构建时自动为你生成 .gz 或 .br 压缩文件,极大减小生产环境的资源体积,加速网站加载。
痛点: 现代 Web 应用构建后的 JavaScript 和 CSS 文件可能很大。虽然服务器(如 Nginx)可以动态压缩它们,但这会消耗 CPU 资源。更高效的方式是直接提供预先压缩好的文件。
解决方案: 该插件在 pnpm build 完成后,会自动使用 Gzip 或 Brotli 算法对大文件进行压缩,生成对应的 .gz 或 .br 文件。你只需配置服务器优先使用这些压缩文件即可。
实战配置与效果
- 安装依赖:
pnpm add -D vite-plugin-compression - 配置
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11
12
13import viteCompression from 'vite-plugin-compression';
export default defineConfig({
plugins: [
viteCompression({
verbose: true, // 是否在控制台输出压缩结果
disable: false, // 是否禁用
threshold: 10240, // 文件大小大于 10kb 才进行压缩
algorithm: 'gzip', // 压缩算法
ext: '.gz', // 文件后缀
}),
],
}); - 效果展示:
执行pnpm build后,查看dist目录。你会发现除了*.js,*.css等文件外,还多出了对应的*.js.gz,*.css.gz文件。将这些文件部署到服务器并配置 Nginx(例如开启gzip_static on;),用户浏览器将直接下载压缩后的文件,首屏加载速度显著提升。
**7. vite-plugin-mkcert https 环境模拟 **
一句话解决什么问题:一条命令搞定本地 HTTPS 开发环境,让你的 localhost 拥有一个浏览器信任的绿色小锁。
痛点: 本地开发时,http://localhost 无法满足一些现代 Web API 的要求(如 Service Workers、Web Crypto API、安全 Cookie),这些 API 强制要求在安全上下文(HTTPS)中运行。手动创建和信任自签名证书流程极其繁琐,且浏览器总是会报不安全警告。
解决方案: 该插件集成了 mkcert 工具,可以自动在你的本地环境中生成一个被信任的证书颁发机构(CA),并为你的项目签发一个有效的 HTTPS 证书。
实战配置与效果
安装依赖:
pnpm add -D vite-plugin-mkcert配置
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11import mkcert from 'vite-plugin-mkcert';
export default defineConfig({
// 必须开启 server.https 才能生效
server: {
https: true
},
plugins: [
mkcert() // 插件的调用非常简单
],
});注意: 首次运行时,插件可能会提示需要管理员(sudo)权限来安装本地 CA,请按提示操作。此操作仅需一次。
效果展示:
再次运行pnpm dev,Vite 将启动一个https://localhost:5173的服务。在浏览器中打开它,你会看到地址栏前面出现了一个安全锁标志,再也不会有任何安全警告,所有需要 HTTPS 的 API 都可以正常调试了。
9.7. 拓展疆界:Vite 的高级架构模式与场景
引言: 在掌握了 Vite 对单页应用(SPA)的极致优化后,我们将目光投向更广阔的领域。本节将探讨 Vite 如何作为底层引擎,优雅地支持多页面(MPA)、库开发、服务端渲染(SSR)乃至与传统后端框架集成等多种复杂的架构模式。我们将从“为何需要”的架构考量出发,深入到“如何实现”的核心配置与最佳实践。
9.7.1. 多页面应用 (MPA):回归与现代化
架构考量
虽然单页应用(SPA)是现代前端的主流,但在某些场景下,多页面应用(MPA)依然是更优选择:
- 内容驱动型网站: 公司官网、营销活动页、博客等,页面之间逻辑独立,MPA 对 SEO 更友好。
- 隔离性要求: 当不同模块(如应用前台和后台管理系统)需要严格的环境和依赖隔离时。
Vite 不仅是 SPA 的利器,同样也能为现代化的 MPA 开发提供顶级的开发体验。
实战:将一个 Vue SPA 改造为 MPA
我们的目标是构建一个项目,它包含两个完全独立的页面:
index.html: 面向普通用户的“前台应用”。admin.html: 面向管理员的“后台应用”。这两个应用将共享底层的 UI 组件和工具函数。
第一步:初始化一个标准的 Vue 3 SPA 项目
这为我们提供了一个熟悉且功能完备的起点。
1 | # 创建一个标准的 Vite + Vue 项目 |
第二步:为 MPA 模式重构项目结构
我们需要创建第二个 HTML 入口和对应的 JavaScript 入口。
- 在项目根目录创建一个
admin文件夹。 - 将根目录的
index.html复制 一份到admin/目录中,作为后台应用的入口。 - 在
src目录下新建一个pages文件夹,用于存放不同页面的入口 JS/TS 文件。 - 将原有的
src/main.ts移动 到src/pages/main.ts。 - 在
src/pages/下 新建 一个admin.ts作为后台应用的入口。 - (可选) 创建一个共享组件,例如
src/components/TheHeader.vue。
重构后的核心文件结构如下:
1 | # mpa-project/ |
第三步:配置 HTML 和 TS 入口
- 修改
index.html: 确保它的<script>标签指向新的main.ts路径。1
<script type="module" src="/src/pages/main.ts"></script>
- 修改
admin/index.html: 确保它的<script>标签指向admin.ts。1
<script type="module" src="/src/pages/admin.ts"></script>
- 编写
admin.ts:
文件路径:src/pages/admin.ts1
2
3
4
5
6
7
8
9
10
11
12import { createApp } from 'vue'
import './style.css'
// 我们可以创建一个独立的后台根组件 AdminApp.vue
// import AdminApp from '../AdminApp.vue'
// 为简化演示,我们直接渲染一段 HTML
const adminApp = document.createElement('div');
adminApp.innerHTML = `
<h1>这是admin页面</h1>
<p>只有管理员才能访问</p>
`;
document.body.appendChild(adminApp);
第四步:配置 vite.config.ts 以识别多入口
这是最关键的一步。我们需要告诉 Vite,我们的项目现在有两个入口,而不是一个。
文件路径: vite.config.ts
1 | import { resolve } from 'path' |
【重要提示】为什么 TypeScript 找不到 path 和 __dirname?
当你像上面这样修改 vite.config.ts 后,TypeScript 可能会立即报错,提示“无法找到模块 ‘path’ 的声明文件”或“找不到名称 ‘__dirname’”。
原因: 你的项目代码(如
.vue和.ts文件)最终是运行在 浏览器环境 的,而vite.config.ts这个文件是运行在 Node.js 环境 的。TypeScript 默认只为浏览器环境提供类型检查,它不认识 Node.js 的内置模块(如path)和全局变量(如__dirname)。解决方案: 我们需要手动安装 Node.js 的类型定义文件,告诉 TypeScript “请相信我,这个配置文件是在 Node.js 环境下运行的”。
1
pnpm add -D @types/node
-D表示这是一个开发依赖,因为它只在开发阶段的类型检查时需要。安装后,错误就会消失,因为 TypeScript 现在有了 Node.js 的“说明书”,能够理解path等 API 了。这在任何需要配置 Node.js 环境脚本的 TypeScript 项目中都是一个标准操作。
第五步:效果验证
开发环境:
运行pnpm dev。现在你可以:- 访问
http://localhost:5173/查看前台应用。 - 访问
http://localhost:5173/admin/或http://localhost:5173/admin/index.html查看后台应用。修改任何一个应用的源文件(包括共享组件),对应的页面都会实现 HMR 热更新,开发体验依然丝滑。
- 访问
生产构建:
运行pnpm build。1
2
3
4
5
6
7
8dist/
├── admin/
│ └── index.html # 后台的 HTML
├── assets/
│ ├── main-[hash].js # 前台的 JS
│ ├── admin-[hash].js # 后台的 JS
│ └── index-[hash].css # 共享或独立的 CSS
└── index.html # 前台的 HTMLVite 成功地为每个入口都生成了独立的 HTML 和关联的资源文件,它们被清晰地组织在
dist目录中,可以直接部署。
通过这个从 SPA 到 MPA 的改造过程,我们掌握了 Vite 处理多页面应用的核心配置。关键在于利用 build.rollupOptions.input 明确告知 Vite 项目的所有 HTML 入口。即使是复杂的 MPA 项目,Vite 依然能提供与 SPA 相媲美的顶级开发体验。
9.7.2. 库模式:打造高质量前端资产
核心目标
当我们开发一个 JS 工具库或 UI 组件库时,目标不再是生成一个可以直接运行的 index.html 应用,而是要发布一个或多个健壮、高效、易用的 JS 文件(以及附带的 CSS 和类型定义),让其他开发者可以在他们的项目中轻松导入和使用。
实战:封装一个 Vue 3 UI 组件并打包为库
场景: 假设我们在多个项目中都需要一个样式统一、功能独特的按钮组件。为了避免在各个项目中重复“CV 大法”(复制粘贴),我们决定将其封装成一个独立的 UI 库 @prorise/button,这章节可以暂时预览一下,我们在后面的教学会带大家手搓一个真正的组件库
第一步:初始化库项目
1 | pnpm create vite prorise-ui-lib -- --template vue-ts |
删除 src/components 目录下的 HelloWorld.vue,并创建一个新的按钮组件。
文件路径: src/components/ProriseButton.vue
1 | <template> |
第二步:创建库入口文件
创建一个 src/index.ts 文件,统一导出库的所有内容。
文件路径: src/index.ts
1 | import ProriseButton from './components/ProriseButton.vue'; |
第三步:配置 vite.config.ts 的库模式 (build.lib)
这是 Vite 库模式的核心。我们需要告诉 Vite,这是一个库,而不是一个应用。
文件路径: vite.config.ts
1 | import { resolve } from 'path'; |
关键挑战与解决方案
仅仅配置 build.lib 还不够,要打造一个“高质量”的库,我们必须解决以下三个关键问题。
挑战一:依赖管理
- 痛点: 我们的
ProriseButton.vue依赖于vue。如果我们将vue的源码一起打包进我们的库文件,而使用者的项目本身也引入了vue,就会导致最终应用中存在 两份 Vue 的代码!这会急剧增大包体积,甚至可能因为版本或实例不一致而引发运行时错误。 - 解决方案: 将
vue声明为peerDependencies(对等依赖),并将其 外部化,即不打包进我们的库。
1 | { |
peerDependencies 的意思是:“嘿,使用我这个库的项目,你自己必须也要安装 Vue 3,我只是‘借用’你的 Vue 来运行。”
修改
vite.config.ts:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17// vite.config.ts
export default defineConfig({
//...
build: {
lib: { /* ... */ },
rollupOptions: {
// 确保外部化处理那些你不想打包进库的依赖
external: ['vue'],
output: {
// 在 UMD 构建模式下为这些外部化的依赖提供一个全局变量
globals: {
vue: 'Vue',
},
},
},
},
});
挑战二:样式处理
- 痛点: 我们组件的样式 (
<style>块) 如何交付给用户? - 解决方案: Vite 在库模式下,默认会自动将所有组件的 CSS 抽离成一个单独的
style.css文件。这是最佳实践,因为它允许用户选择是否引入样式,或者用自己的样式覆盖它。我们无需额外配置。
挑战三:类型定义
- 痛点: 我们的库是用 TypeScript 写的,如何让使用我们库的 TS 用户获得完美的类型提示和自动补全?
- 解决方案: 我们需要生成
.d.ts类型声明文件,并正确配置package.json。
配置
tsconfig.json:开启declaration选项。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25{
// TypeScript 编译选项
"compilerOptions": {
// 生成 .d.ts 声明文件
"declaration": true,
// 只生成声明文件,不生成 JavaScript 文件
"emitDeclarationOnly": true,
// 声明文件输出目录
"outDir": "dist/types",
// 启用严格模式
"strict": true
},
// 包含的源文件目录
"include": ["src"],
// 不包含任何单独的文件
"files": [],
// 项目引用配置
"references": [
// 应用程序的 TypeScript 配置
{ "path": "./tsconfig.app.json" },
// Node.js 环境的 TypeScript 配置
{ "path": "./tsconfig.node.json" }
]
}添加构建脚本: 在
package.json中添加一个专门用于生成类型文件的脚本。1
2
3
4"scripts": {
"build:types": "vue-tsc --declaration --emitDeclarationOnly --outDir dist/types",
"build": "npm run build:types && vite build"
}现在运行
pnpm build,它会先生成类型文件,然后再进行打包。配置
package.json的导出字段: 这是最后,也是最关键的一步,告诉使用者的项目如何找到我们的代码和类型。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23{
"name": "@prorise/ui-lib",
"version": "1.0.0",
"private": false, // 必须为 false 才能发布
"files": [ // 定义哪些文件会被发布到 npm
"dist"
],
"main": "./dist/prorise-ui.umd.js", // CommonJS/UMD 入口
"module": "./dist/prorise-ui.es.js", // ES Module 入口
"types": "./dist/types/index.d.ts", // TypeScript 类型定义入口
"exports": {
".": {
"import": "./dist/prorise-ui.es.js",
"require": "./dist/prorise-ui.umd.js",
"types": "./dist/types/index.d.ts"
},
"./style.css": "./dist/style.css" // 暴露 CSS 文件
},
"peerDependencies": {
"vue": "^3.0.0"
},
// ...
}
最终构建与验证
运行 pnpm build,dist 目录的结构将非常专业:
1 | dist/ |
现在,这个库已经可以发布到 NPM,并在任何 Vue 3 项目中通过 import { ProriseButton } from '@prorise/ui-lib' 和 import '@prorise/ui-lib/style.css' 来使用了。
9.7.3. 与传统后端框架的“混合”模式
场景定义
我们来设想一个在企业中极为常见的场景:你正在维护一个由 Spring Boot 构建的、使用 Thymeleaf 作为模板引擎的电商网站。现在,你需要在一个由后端渲染的商品详情页上,嵌入一个由 Vite + Vue/React 开发的、功能复杂的“商品3D定制”组件。
在这个“混合”模式下,我们将让新旧技术协同工作:Spring Boot 继续负责路由、数据接口和页面骨架的渲染,而 Vite 则扮演前端资源构建管道的角色,专门负责编译、打包和提供现代化前端组件所需的 JS 和 CSS 资源。
生产环境工作流:Manifest 与后端服务的“契约”
核心挑战:在生产环境,Vite 构建出的资源文件名都带有哈希值(如 main-a1b2c3d4.js)以实现长效缓存。我们的 Spring Boot Thymeleaf 模板,如何能动态地知道这个每次构建都会变化的、正确的文件名呢?
解决方案:通过 build.manifest 文件。这是 Vite 与后端服务之间沟通的“契约”。
第一步:配置 Vite (vite.config.ts)
我们需要告诉 Vite 两件事:1. 开启 manifest 生成。 2. 将构建产物输出到 Spring Boot 约定的静态资源目录中 (src/main/resources/static)。
1 | // vite.config.ts |
第二步:在 Spring Boot 中创建 manifest.json 解析服务
我们需要一个 Java 服务来读取和解析 dist/manifest.json 文件,以便在模板中调用。
- 添加依赖: 确保你的
pom.xml中有 JSON 解析库,如Jackson(spring-boot-starter-web 默认包含)。 - 创建服务类:
文件路径:src/main/java/com/prorise/vite/ViteAssetResolver.java1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48package com.prorise.vite;
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import org.springframework.stereotype.Service;
import org.springframework.util.ResourceUtils;
import java.io.File;
import java.io.IOException;
public class ViteAssetResolver {
private final ObjectMapper objectMapper = new ObjectMapper();
private JsonNode manifest;
// 服务启动时,读取并解析 manifest.json 文件
public ViteAssetResolver() {
try {
// 从 Spring Boot 的 classpath 中查找 manifest.json
File file = ResourceUtils.getFile("classpath:static/dist/manifest.json");
this.manifest = objectMapper.readTree(file);
} catch (IOException e) {
// 在生产环境中,如果找不到 manifest 文件,应该抛出异常或记录严重错误
// 在开发中可以忽略,因为我们不会使用它
this.manifest = null;
System.err.println("Error reading manifest.json: " + e.getMessage());
}
}
// 公共方法,根据源文件名(如 src/main.ts)获取最终带哈希的 JS 文件路径
public String getJs(String entry) {
if (manifest == null || !manifest.has(entry)) return "";
return "/dist/" + manifest.get(entry).get("file").asText();
}
// 公共方法,获取入口文件关联的所有 CSS 文件路径
public String[] getCss(String entry) {
if (manifest == null || !manifest.has(entry) || !manifest.get(entry).has("css")) return new String[0];
JsonNode cssNode = manifest.get(entry).get("css");
String[] cssFiles = new String[cssNode.size()];
for (int i = 0; i < cssNode.size(); i++) {
cssFiles[i] = "/dist/" + cssNode.get(i).asText();
}
return cssFiles;
}
}
第三步:在 Thymeleaf 模板中动态注入资源
现在,我们可以在 Thymeleaf 模板中,通过调用 ViteAssetResolver 服务来动态生成 <script> 和 <link> 标签。
文件路径: src/main/resources/templates/product-detail.html
1 |
|
开发环境工作流:代理与 HMR
在开发时,我们的目标是:访问由 Spring Boot 服务(http://localhost:8080)提供的页面,但页面上的 Vue/React 组件,又能享受到 Vite Dev Server(http://localhost:5173)带来的 HMR 和极速更新。
这同样需要后端与 Vite 协同。我们需要让 Thymeleaf 模板能够判断当前环境,并加载不同的资源。
Thymeleaf 模板 (增加开发环境判断)
1 | <body> |
通过这种方式,我们完美地实现了开发与生产环境的隔离。开发时,前端资源由 Vite 实时提供,享受极致的开发体验;生产部署时,则加载由 Vite 精心构建和优化的静态资源。